従来のキーワード検索の限界と課題
フードデリバリーアプリで"雨の日に温まる食べ物"と検索したのに、"該当する結果が0件見つかりました"と表示される――これは多くのユーザーにとって馴染みのある残念な体験でしょう。LIKE '%温まる%'やPostgreSQLのFull-Text Search(tsvector)といった従来の手法は、単語の表面的な文字列の一致しか判定できません。そのため、メニューに"ビーフシチュー"や"熱々の鶏粥"と書かれていても、キーワードが完全一致しないため検索結果から完全に除外されてしまいます。
セマンティック検索(semantic search)を実現するために、多くの開発チームがまず思い浮かべるのは、Pinecone、Weaviate、Qdrantなどの専用Vector Databaseクラスターの構築です。このアプローチは確かに効果的ですが、相応のコストがかかります。1クラスターあたり月額少なくとも70〜100ドルが必要になる上、メインDBとVector DBの間で双方向同期を行うCDC(Change Data Capture)の仕組みも構築しなければなりません。さらに、データの不整合リスクや、システム内に新たな単一障害点(SPOF: Single Point of Failure)を生み出す原因にもなります。
現在のWebプロジェクトの多くは、すでにPostgreSQLを採用しています。既存のデータベースで十分に賄えるのであれば、わざわざ新たなインフラを抱え込む必要はあるのでしょうか?
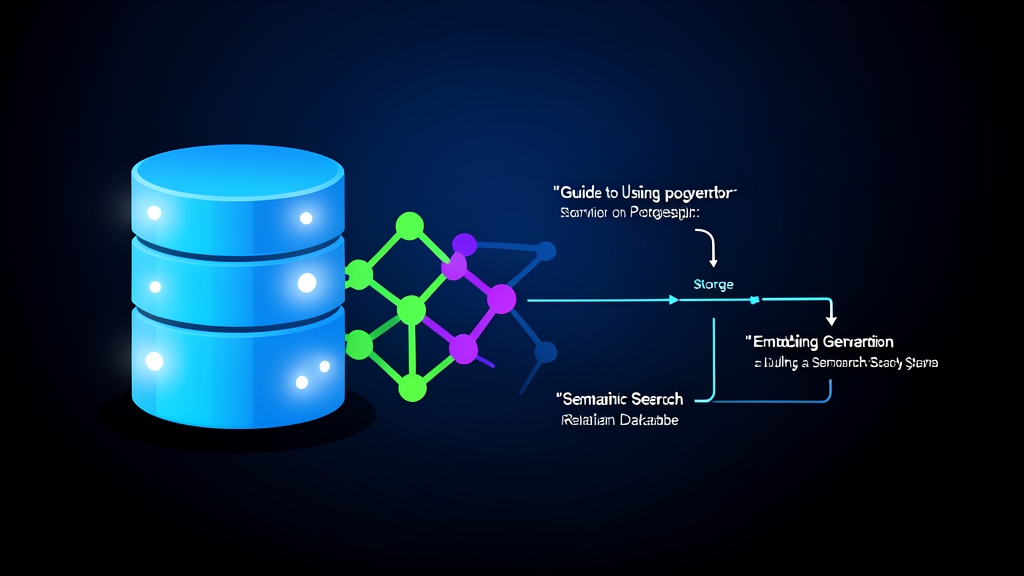
その答えとなるのがpgvectorです。C言語で書かれたこのオープンソース拡張機能(extension)は、PostgreSQLを本格的なVector Databaseへと変貌させ、usersやordersといったお馴染みのテーブル内で直接Vector Embeddingsの保存や類似度計算を可能にします。
コアコンセプト:Vector Embeddingsとセマンティック検索
Vector Embeddings(ベクトル埋め込み)とは?
例えば、人の性格を「外向性」「忍耐力」「ユーモアのセンス」の3つの指標で、0から1のスケールでスコア付けすると想像してみてください。ある人物の特徴は、[0.85, 0.20, 0.95]のような座標として簡潔に表現できます。
AIにおけるVector Embeddingもまったく同じ仕組みです。3つの基準で評価する代わりに、大規模言語モデル(OpenAIのtext-embedding-3-smallなど)はテキストを1,536次元の実数配列へと変換します。この数値列によって、テキストの意味が多次元の数学空間上に位置付けられます。
- "猫が日向ぼっこをしている"と"子猫が外で寝ている"の2文は意味が似ているため、空間上の座標は非常に近い位置に配置されます。
- 一方、"今日の米ドル為替レートが急落した"という文は文脈が全く異なるため、座標は大きく離れた位置にマッピングされます。
セマンティック検索はどのように機能するのか?
単語の一致数をカウントするのではなく、セマンティック検索は検索クエリのベクトルと保存された各ドキュメントのベクトルとの間の幾何学的距離を計算します。代表的な距離指標(メトリクス)は以下の2つです。
- コサイン距離(Cosine Distance):テキストの長さに依存せず、2つのベクトル間の角度の開きを測定します。現在のほとんどのテキスト埋め込みモデルにおいて最適な選択肢です。
- L2 / ユークリッド距離(Euclidean Distance):空間内の2点間を結ぶ直線の長さを測定します。
pgvectorはこの課題をどう解決するのか?
pgvectorはvector(n)データ型(最新バージョンでは最大16,000次元まで対応)を提供し、代表的な2つのベクトルインデックスアルゴリズムをサポートしています。
- IVFFlat:k-meansアルゴリズムによってベクトルを複数のクラスター(クラスタ)に分割します。インデックス構築が高速でメモリ消費量も非常に少ないですが、クラスターをトレーニングするためにテーブルにあらかじめデータが存在している必要があり、データセットが頻繁に変動すると再現率(recall)が低下する傾向があります。
- HNSW (Hierarchical Navigable Small World):近傍ベクトルをリンクさせた階層型のグラフ構造を構築します。HNSWは優れたクエリ速度と95〜98%以上の高い精度を誇ります。唯一のトレードオフはメモリ消費量が多い点です(1,536次元のベクトル100万件あたり約1.5GB〜2GBのRAMが必要)。
実践:PostgreSQLを使ったセマンティック検索システムの構築
ステップ1:pgvector対応のPostgreSQLを起動する
最も手軽な方法は、pgvector開発チームが提供する公式Dockerイメージを使用することです。
# pgvector拡張機能がプリインストールされたPostgreSQL 16を実行
docker run -d \
  --name pgvector-demo \
  -e POSTGRES_USER=postgres \
  -e POSTGRES_PASSWORD=mysecretpassword \
  -e POSTGRES_DB=knowledge_base \
  -p 5432:5432 \
  pgvector/pgvector:pg16
ステップ2:拡張機能を有効化してスキーマを作成する
psqlやTablePlusなどでデータベースに接続し、以下のSQL文を実行します。
-- vector拡張機能を有効化
CREATE EXTENSION IF NOT EXISTS vector;

-- 1536次元のベクトルを保存するdocumentsテーブルを作成
CREATE TABLE documents (
    id BIGSERIAL PRIMARY KEY,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL,
    category VARCHAR(50) NOT NULL,
    embedding vector(1536),
    created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP
);
ステップ3:HNSW検索インデックスを作成する
インデックスがない場合、PostgreSQLはテーブル全体のスキャン(Sequential Scan)を余儀なくされ、クエリ時間はレコード数に比例して線形に増加します。HNSWインデックスとコサイン距離演算子vector_cosine_opsを組み合わせることで、検索クエリを大幅に最適化できます。
CREATE INDEX idx_documents_embedding_hnsw
ON documents
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);パラメータm = 16はグラフ上の各ノードの最大双方向リンク数を定義し、ef_construction = 64はインデックス構築時の探索範囲を決定します。このデフォルト設定は、多くの本番アプリケーションにとって十分に実用的なバランスです。
ステップ4:Pythonパイプライン:埋め込み生成、保存、検索
以下のスクリプトは、OpenAIによるEmbedding生成、データベースへの保存、そしてセマンティック検索の実行というエンドツーエンドの一連の流れを示しています。
import psycopg2
from openai import OpenAI

client = OpenAI(api_key="sk-your-openai-api-key")

def get_embedding(text: str) -> list[float]:
    response = client.embeddings.create(
        input=text,
        model="text-embedding-3-small"
    )
    return response.data[0].embedding

conn = psycopg2.connect(
    dbname="knowledge_base",
    user="postgres",
    password="mysecretpassword",
    host="localhost",
    port="5432"
)
cursor = conn.cursor()

# 1. サンプルデータの投入
sample_data = [
    ("返品・返金ポリシー", "パッケージが未開封のままであれば、30日以内であれば全額返金いたします。", "policy"),
    ("保証規約", "メーカー側のハードウェア障害が発生した場合、12か月以内であれば無償交換をサポートします。", "warranty"),
    ("おすすめグルメ", "肌寒い夜には、熱々で酸味と辛味が効いた海鮮キムチ鍋が最高のチョイスです。", "lifestyle")
]

for title, content, cat in sample_data:
    emb = get_embedding(content)
    cursor.execute(
        "INSERT INTO documents (title, content, category, embedding) VALUES (%s, %s, %s, %s)",
        (title, content, cat, emb)
    )
conn.commit()

# 2. セマンティック検索の実行
query_text = "不良品が届いたので返金してもらいたいのですが、どうすればいいですか?"
query_vector = get_embedding(query_text)

# HNSWの検索精度を調整(デフォルトは40)
cursor.execute("SET hnsw.ef_search = 100;")

# <=> 演算子はコサイン距離を計算:値が小さいほど類似度が高い
cursor.execute("""
    SELECT id, title, content, (embedding <=> %s::vector) AS distance
    FROM documents
    ORDER BY distance ASC
    LIMIT 2;
""", (query_vector,))

for row in cursor.fetchall():
    print(f"[{row[1]}] 距離: {row[3]:.4f}")
    print(f"内容: {row[2]}\n")

cursor.close()
conn.close()
真価を発揮するメタデータフィルタリング(Metadata Filtering)
上記の例において、<=>演算子は[0, 2]の範囲でコサイン距離を返します(計算式は1 - cosine_similarityに相当)。スコアが0に近いほど、意味的な類似度が高いことを示します。検索クエリに"30日"や"パッケージ"といった単語が含まれていないにもかかわらず、"返品・返金ポリシー"のドキュメントが最上位にランク付けされました。
しかし、pgvectorの真の強みは、単一のSQLクエリ内でリレーショナル条件とベクトル検索を同時に組み合わせられる点(ハイブリッドフィルタリング)にあります。
-- カテゴリと作成日時のフィルタリングを組み合わせたベクトル検索
SELECT title, content
FROM documents
WHERE category = 'policy'
  AND created_at >= '2024-01-01'
ORDER BY embedding <=> '[0.012, -0.045, ...]'::vector
LIMIT 5;
独立したVector Databaseを使用する場合、まずVector DBから上位100件のIDを取得し、その後にPostgreSQL側でtenant_idやis_deletedなどのフィルタリングを行うのが一般的です。しかし、フィルタ条件によってデータが大きく絞り込まれると、結果が空になったり件数が不足したりする問題が発生します。一方pgvectorなら、PostgreSQLのクエリオプティマイザが最適な実行計画(Execution Plan)を自動的に算出し、インデックススキャンの前後にフィルタ処理を効率的に適用してくれます。
どのような場面でpgvectorを採用すべきか?
pgvectorはあらゆるシナリオでMilvusやPineconeを完全に代替するために作られたわけではありません。しかし、以下のようなケースにおいて理想的な出発点となります。
- データ規模が500万ベクトル未満:標準的なハードウェア構成(4〜8 vCPU、16〜32 GB RAM)があれば、pgvectorはHNSWクエリをレイテンシ15ms未満で非常にスムーズに処理できます。
- ACID特性とセキュリティの担保が必要な場合:PostgreSQLが持つ行レベルセキュリティ(RLS: Row-Level Security)、ACIDトランザクション、実績あるバックアップ/リストアの仕組みをそのまま活用できます。
- 少人数・小規模な開発チーム:外部サービスを1つ減らすことで、インフラコストと運用保守の手間の双方を大幅に削減できます。
より複雑な専用システムへの移行を検討する前に、まずはpgvectorから始めることを強くお勧めします。プロダクトの初期フェーズにおいては、アーキテクチャをシンプルに保つことこそが最善の戦略です。