深夜2時、突如としてPagerDutyのアラートが鳴り響きました。Node.js APIが一斉に504 Gateway Timeoutを返し、同時に本番環境のPostgreSQLクラスタはCPU使用率100%に張り付いていました。pg_stat_activityとGrafanaを確認すると、原因は一目瞭然でした。インデックスのない45万行以上のベクトルデータに対して、類似商品検索のクエリがシーケンシャルスキャン(sequential scan)を実行していたのです。リクエストあたりのレイテンシは45msから8,000ms超へと跳ね上がっていました。
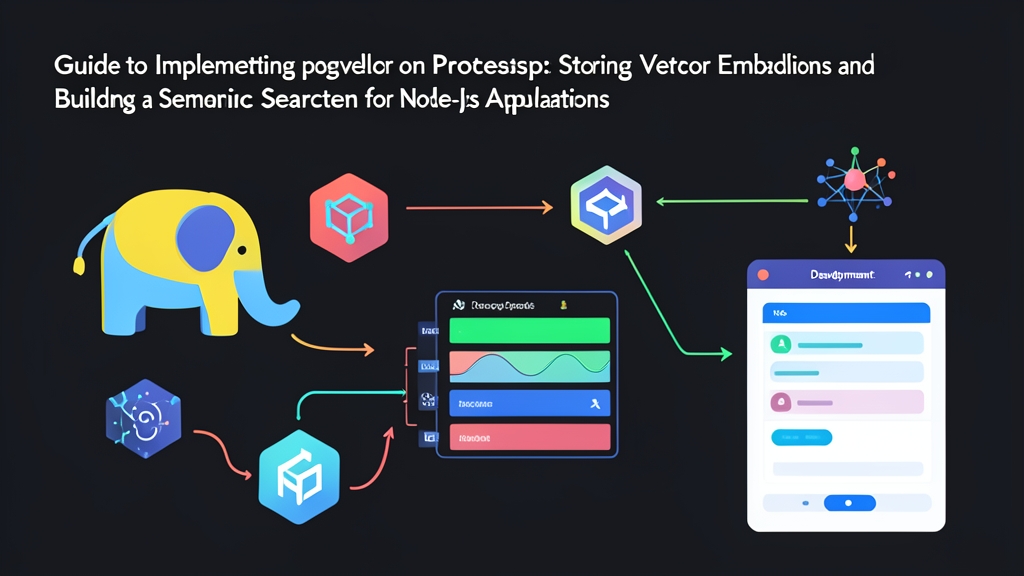
チームでセマンティック検索やRAG(Retrieval-Augmented Generation)を構築したいものの、PineconeやMilvusに毎月数千ドルも払いたくない場合、pgvectorは最も現実的な選択肢です。適切なチューニングさえ行えば、PostgreSQLでも数百万件規模のベクトルを十分に処理できます。本記事では、私たちが深夜の障害からシステムを復旧させ、パイプラインを一から標準化した手順を共有します。
1. クイックスタート:5分でテスト環境を構築する
障害発生中に拡張機能(extension)をソースからビルドするような時間の無駄は避けるべきです。ステージング環境やローカルでの検証環境を手早く用意するなら、pgvector公式のDockerイメージを使用するのが最も手軽です。
Dockerでpgvector対応PostgreSQLを起動する
# pgvector同梱のPostgreSQLコンテナを起動
docker run -d \
  --name postgres-vector \
  -e POSTGRES_USER=appuser \
  -e POSTGRES_PASSWORD=secretpassword \
  -e POSTGRES_DB=vector_db \
  -p 5432:5432 \
  pgvector/pgvector:pg16
拡張機能の有効化とスキーマの作成
データベースに接続し、拡張機能を有効化します。注意点として、vector(n)のデータ型は使用する埋め込みモデルの次元数と完全に一致させる必要があります。例えば、OpenAIのtext-embedding-3-smallは1,536次元ですが、all-MiniLM-L6-v2のようなローカルモデルは384次元です。
-- pgvector拡張機能を有効化
CREATE EXTENSION IF NOT EXISTS vector;

-- 1536次元のベクトルを持つドキュメントテーブルを作成
CREATE TABLE documents (
    id SERIAL PRIMARY KEY,
    content TEXT NOT NULL,
    embedding vector(1536)
);
データの挿入とコサイン類似度クエリの実行
-- テスト用データの挿入
INSERT INTO documents (content, embedding)
VALUES ('Node.jsとPostgreSQLのタイムアウトエラーの解決', '[0.012, -0.023, 0.045, ...]'); -- 1536次元ベクトル

-- コサイン距離(<=>)に基づいて類似度上位5件のドキュメントを取得
SELECT id, content, 1 - (embedding <=> '[0.010, -0.020, 0.040, ...]') AS similarity
FROM documents
ORDER BY embedding <=> '[0.010, -0.020, 0.040, ...]' ASC
LIMIT 5;
2. pgvectorの仕組みと動作原理
pgvectorは、PostgreSQLにvectorデータ型を追加します。これに伴い、多次元空間内の点同士の距離を計算するための幾何演算子が提供されます。
主要な3つの距離演算子
- L2距離(ユークリッド距離)
<->: 2つのベクトル間の直線距離を測定します。ベクトルの絶対的な大きさが重要な意味を持つ場合(画像処理などで一般的)に適しています。 - 負の内積(Negative Inner Product)
<#>: 内積の符号を反転させた値です。PostgreSQLのソート順がASC(昇順)であるため、類似度が最も高いベクトルが先頭に来るように負の値を返します。ベクトルが正規化済み(L2ノルム = 1)であれば、計算速度が最も高速になります。 - コサイン距離
<=>: 2つのベクトル間の角度を測定し、計算式は1 - コサイン類似度となります。テキストの長さによる意味の歪みを受けにくいため、自然言語処理(NLP)におけるデファクトスタンダードとなっています
Node.jsバックエンドへの統合
Node.jsの標準的なpgドライバーは、pgvectorと直接互換性があります。浮動小数点数の配列をPostgreSQL形式の文字列にシリアライズするだけで扱えます。
import pg from 'pg';
import OpenAI from 'openai';

const { Pool } = pg;
const pool = new Pool({
  connectionString: process.env.DATABASE_URL || 'postgresql://appuser:secretpassword@localhost:5432/vector_db',
  max: 20,
  idleTimeoutMillis: 30000,
});

const openai = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

async function semanticSearch(userQuery, limit = 5) {
  // 1. ユーザーのクエリから埋め込みベクトルを生成
  const embeddingResponse = await openai.embeddings.create({
    model: 'text-embedding-3-small',
    input: userQuery,
  });
  const queryVector = embeddingResponse.data[0].embedding;

  // 2. 配列を文字列 '[x1,x2,x3,...]' に変換
  const vectorString = JSON.stringify(queryVector);

  // 3. コサイン距離に基づいて上位ドキュメントを検索
  const query = `
    SELECT id, content, 1 - (embedding <=> $1::vector) AS similarity
    FROM documents
    ORDER BY embedding <=> $1::vector ASC
    LIMIT $2;
  `;

  const client = await pool.connect();
  try {
    const res = await client.query(query, [vectorString, limit]);
    return res.rows;
  } finally {
    client.release();
  }
}

// 実行サンプル
semanticSearch('PostgreSQLデータベースをスケールさせる方法')
  .then(results => console.log('検索結果:', results))
  .catch(err => console.error('クエリエラー:', err));
3. インデックス作成:本番環境の過負荷を防ぐ切り札
なぜ45万行のテーブルでデータベースが過負荷に陥ったのでしょうか。インデックスがないデフォルトの状態では、ORDER BY embedding <=> ...を実行するとデータベースは厳密最近傍探索(Exact Nearest Neighbor / KNN)を余儀なくされます。つまり、50件の同時リクエストが発生した場合、PostgreSQLは毎秒2,250万回もの距離計算を行わなければならない計算になります。
レイテンシを数秒から25ms未満に短縮するには、インデックスを用いて近似最近傍探索(Approximate Nearest Neighbor / ANN)に移行する必要があります。
IVFFlatか、それともHNSWか?
- IVFFlat(Inverted File Flat): 空間をクラスタ(ボロノイ領域)に分割します。インデックスの作成が高速で、メモリ消費も少なくて済みます。大きなデメリットとして、効果的なインデックスを作成するにはテーブルに十分なデータが蓄積されるのを待つ必要があり、データの分布に偏りがある場合は再現率(Recall)が大幅に低下する点が挙げられます。
- HNSW(Hierarchical Navigable Small World): 多層グラフを構築する手法です。構築に時間がかかり、IVFFlatと比べて1.5〜2倍のメモリを消費します。しかしその代わり、クエリ速度は圧倒的に高速で、再現率も95%〜99%と安定して高い精度を維持できます。現在の本番環境においては、HNSWが常に第一の選択肢となります。
推奨されるHNSWインデックスの設定
-- 現在のセッションでインデックス構築を高速化するため一時的にRAMを多めに割り当てる
SET maintenance_work_mem = '2GB';

-- コサイン距離演算用のHNSWインデックスを作成
CREATE INDEX documents_embedding_hnsw_idx
ON documents
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
各パラメータの意味:
m = 16: グラフ内の各ノードが保持する最大双方向リンク数。大規模なデータセットでより高い再現率が必要な場合は、24または32に引き上げます。ef_construction = 64: インデックス構築時の探索キューのサイズ。値が大きいほどグラフの精度が向上しますが、構築にかかる時間も長くなります。hnsw.ef_search: クエリ実行時の探索パラメータ。デフォルトは40です。さらなるクエリの高速化が必要な場合は20に下げ、より高い検索精度が必要な場合はSET hnsw.ef_search = 80;のように100程度まで引き上げます。
4. 障害対応から得た4つの実践的な教訓
障害を乗り切ることと、システムを長期的に安定稼働させ続けることは別の課題です。以下に、押さえておくべき重要なポイントをまとめました。
1. 完全切り替え前にシャドウトラフィックで検証する
ElasticsearchやILIKE検索からpgvectorへの移行を、一度のデプロイで一気に行うのは避けましょう。Node.jsからpgvectorへ少なくとも3日間はクエリを並行送信(シャドウトラフィック)させます。p95/p99のレイテンシを記録し、Mean Reciprocal Rank(MRR)などの指標を測定して、検索品質の低下がないことを確認してください。
2. コネクションプールとRAMの徹底管理
クエリ速度を20ms未満に保つには、HNSWインデックス全体がRAM(shared_buffersおよびOSキャッシュ)上に完全に収まっている必要があります。1,536次元のベクトル50万件に対するHNSWインデックスは、約1.6GB〜2GBのメモリを消費します。Node.jsのmaxコネクション数は15〜25程度に設定するか、トランザクションモードのPgBouncerを導入してください。過剰にコネクションを開くとPostgreSQLのメモリが枯渇し、LinuxのOOM Killerが発動するリスクがあります。
3. ベクトル専用テーブルの分離
1,536次元のベクトルは1行あたり約6KBを消費します。長文のTEXT列やJSONB列と同じテーブルにベクトルを同居させると、テーブルサイズが急速に肥大化します。その結果、PostgreSQLのキャッシュページが著しく希薄化してしまいます。そのため、ベクトル専用のテーブルとして分離することをお勧めします。
-- 通常のビジネスロジック用テーブル
CREATE TABLE articles (
    id SERIAL PRIMARY KEY,
    title VARCHAR(255) NOT NULL,
    content TEXT NOT NULL
);

-- ベクトル専用テーブル(検索結果の取得時にJOINする)
CREATE TABLE article_embeddings (
    article_id INT PRIMARY KEY REFERENCES articles(id) ON DELETE CASCADE,
    embedding vector(1536) NOT NULL
);
4. RRFを組み合わせたハイブリッド検索の導入
セマンティック検索は文章の意図を汲み取る能力に長けていますが、特定のエラーコード(ECONNRESETなど)や型番・SKU(SKU-8821)などの完全一致検索では的外れな結果を返すことがあります。PostgreSQL標準の全文検索(tsvector)とpgvectorを組み合わせるハイブリッド検索の導入を推奨します。Reciprocal Rank Fusion(RRF)アルゴリズムを用いて双方のスコアを統合することで、意味的な文脈を捉えつつ、キーワードの完全一致にも強い高精度な検索を実現できます。