開発者の永遠の悪夢:ローカルでは通るのにCIで失敗するテスト
バックエンドエンジニアなら誰もが一度は経験したことがあるでしょう。ローカル環境でテストファイルを1つずつ個別に実行すると100%成功するのに、テストスイート全体をまとめて実行したりCI/CDにプッシュした途端、何十ものテストケースが一斉に赤く失敗する現象です。
私たちのチームも、約5万行の決済サービスをリファクタリングした際にこの問題に痛いほど直面しました。コアロジックを安心して変更するため、PostgreSQLとRedis間のトランザクションフローに対する統合テスト(Integration Test)を網羅しようとしました。しかし結果は、最初の1週間でフレイキーテスト(Flaky Test:不安定なテスト)の発生率が35%に達してしまったのです。
原因は些細なことでした。先に実行されたテストケースがレコードを挿入したままロールバックを忘れており、後続のテストケースがUNIQUE制約違反で即座にエラーを起こしていたのです。データベースにゴミデータを残した犯人のテストを特定するだけで、チーム全体で丸2日を費やす羽目になりました。
さらに、チームメンバーごとに実行しているデータベースのバージョンが異なっていました。HomebrewでPostgres 14をインストールしている人もいれば、固定のDocker環境でPostgres 16を動かしている人もいました。その結果、JSONBのクエリやトランザクションの挙動がマシンごとに明確に食い違ってしまったのです。
テストスイートを不安定にする3大要因
失敗するテスト環境を分析すると、ほとんどの問題は次の3つの原因に行き着きます。
- 共有状態(テストデータの汚染): テストスイート全体が同一のデータベースインスタンスを参照している状態です。
TRUNCATE TABLEやFLUSHALLの漏れが1箇所でもあるだけで、後続のテストは即座に不正なデータの影響を受けてしまいます。 - ポート競合(Port Collision): テストの高速化のため、VitestやJestなどの最新テストランナーはデフォルトで複数のワーカースレッドを並列実行します。4つのワーカーが同時にポート
5432や6379へアクセスすると、確実に競合状態(レースコンディション)が発生します。 - 過剰なモックの罠(Over-mocking): テストを50msで終わらせるためにPrisma、TypeORM、ioredisなどをすべてモック化してしまうケースも少なくありません。しかしその代償として、テストの信頼性は失われます。モックでは本番のデッドロックを警告できず、スキーマの不整合を検知できず、RedisのTTLロジックも検証できません。
よくある2つの暫定的なアプローチとその限界
適切なツールにたどり着く前、エンジニアリングチームはよく次の2つの近道を選びがちです。
1. インメモリライブラリの利用(SQLite、redis-mock)
PostgreSQLをインメモリのSQLiteに置き換え、Redisをredis-mockで代用する手法です。
- メリット: 動作が非常に高速で、メモリ消費が少なく、Dockerのセットアップも不要です。
- デメリット: SQLiteとPostgreSQLではSQL方言が大きく異なります。
ON CONFLICT DO UPDATE構文やUUID型、複雑なJSONBクエリ、アドバイザリロック(Advisory Lock)の検証ができません。同様に、redis-mockもRedis StreamsやカスタムLuaスクリプトには対応できません。
2. Docker Composeによるコンテナの事前起動
docker-compose.test.ymlを用意し、テストランナーの実行前にコンテナを起動しておく手法です。
- メリット: 100%本物のデータベースおよびキャッシュエンジン上で実行できます。
- デメリット: シェルスクリプト等でコンテナのライフサイクルを手動管理する必要があります。開発者がテスト実行前に
docker compose upを叩き忘れることもよくあります。何より、固定ポートを共有するため、テストファイルの安全な並列実行が困難です。
根本的な解決策:Testcontainersによるインフラのコード管理
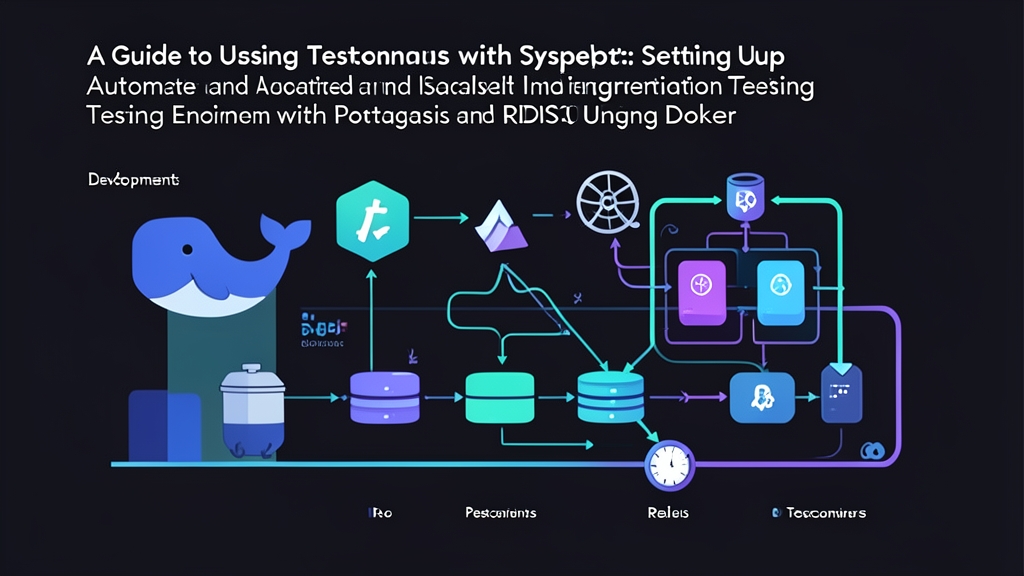
外部スクリプトに依存する代わりに、テストコード自体でコンテナのライフサイクルを管理できます。Testcontainersを使用すると、TypeScriptコードから直接、本物のDockerコンテナを起動・設定・破棄できるようになります。
テストスイートが開始されると、指定されたDockerイメージが自動的にプルされます。コンテナはランダムな動的ポート(例:5432の代わりに49152など)に自動マッピングされるため、ポート競合のリスクを完全に排除できます。
さらに、TestcontainersにはRyukというサイドカーコンテナが付属しています。Ryukはテストプロセスを監視し、予期せぬクラッシュを含めNode.jsが終了した際に、関連するすべてのコンテナを自動でクリーンアップします。ゴミプロセスが残ってマシンのメモリを圧迫することもありません。
必要なパッケージのインストール
Vitestを使用するTypeScriptプロジェクトに必要な依存パッケージをインストールします。
npm install -D vitest typescript @types/node
npm install -D testcontainers @testcontainers/postgresql @testcontainers/redis
npm install pg ioredis
npm install -D @types/pg
独立したテスト環境の構築
起動とリソース解放のロジックをカプセル化したヘルパークラスを作成します。
// test/test-env.ts
import { PostgreSqlContainer, StartedPostgreSqlContainer } from '@testcontainers/postgresql';
import { RedisContainer, StartedRedisContainer } from '@testcontainers/redis';
import { Pool } from 'pg';
import Redis from 'ioredis';

export class TestEnvironment {
  private pgContainer?: StartedPostgreSqlContainer;
  private redisContainer?: StartedRedisContainer;
  public dbPool?: Pool;
  public redisClient?: Redis;

  async start() {
    // プロジェクトの実環境に合わせたPostgresコンテナを起動
    this.pgContainer = await new PostgreSqlContainer('postgres:16-alpine')
      .withDatabase('test_db')
      .withUsername('test_user')
      .withPassword('test_pass')
      .start();

    // Redisコンテナを起動
    this.redisContainer = await new RedisContainer('redis:7-alpine').start();

    // Testcontainersが割り当てた動的ポートを含む接続URIを取得
    this.dbPool = new Pool({
      connectionString: this.pgContainer.getConnectionUri(),
    });

    this.redisClient = new Redis(this.redisContainer.getConnectionUrl());

    // テスト用テーブルを作成
    await this.dbPool.query(`
      CREATE TABLE IF NOT EXISTS users (
        id SERIAL PRIMARY KEY,
        email VARCHAR(255) UNIQUE NOT NULL,
        name VARCHAR(100) NOT NULL
      );
    `);
  }

  async stop() {
    // クライアントの接続を切断
    await this.dbPool?.end();
    this.redisClient?.disconnect();

    // コンテナの停止と削除
    await this.pgContainer?.stop();
    await this.redisContainer?.stop();
  }
}
統合テストのシナリオ作成
以下は、ユーザー情報をPostgreSQLに保存し、セッショントークンをRedisにキャッシュする実践的なテストケースです。
// test/user-service.test.ts
import { describe, it, expect, beforeAll, afterAll, beforeEach } from 'vitest';
import { TestEnvironment } from './test-env';

describe('User & Session Integration Test', () => {
  const env = new TestEnvironment();

  // 初回実行時はDockerイメージのプルに時間がかかるため60秒を設定
  beforeAll(async () => {
    await env.start();
  }, 60000);

  // テストスイート全体の終了後にクリーンアップを実行
  afterAll(async () => {
    await env.stop();
  });

  // テスト間のデータ干渉を防ぐため、各テストケースの実行前にデータをリセット
  beforeEach(async () => {
    await env.dbPool?.query('TRUNCATE TABLE users RESTART IDENTITY CASCADE;');
    await env.redisClient?.flushdb();
  });

  it('PostgreSQLへのユーザー保存とRedisへのセッション保存が正常に動作すること', async () => {
    const email = '[email protected]';
    const name = 'Alex Dev';

    // 1. 本物のPostgreSQLに対する操作
    const insertRes = await env.dbPool!.query(
      'INSERT INTO users (email, name) VALUES ($1, $2) RETURNING id, email, name;',
      [email, name]
    );
    const newUser = insertRes.rows[0];

    expect(newUser.id).toBeDefined();
    expect(newUser.email).toBe(email);

    // 2. 本物のRedisキャッシュに対する操作
    const sessionKey = `session:${newUser.id}`;
    const token = 'jwt-mock-secret-xyz';
    await env.redisClient!.set(sessionKey, token, 'EX', 3600);

    const cachedToken = await env.redisClient!.get(sessionKey);
    expect(cachedToken).toBe(token);
  });

  it('PostgreSQLのUNIQUE制約によりメールアドレスの重複エラーが正しく検知されること', async () => {
    const email = '[email protected]';

    await env.dbPool!.query('INSERT INTO users (email, name) VALUES ($1, $2);', [email, 'User A']);

    // データベース層の制約をテストするために意図的に重複データを挿入
    await expect(
      env.dbPool!.query('INSERT INTO users (email, name) VALUES ($1, $2);', [email, 'User B'])
    ).rejects.toThrow(/duplicate key value/);
  });
});
Testcontainersのパフォーマンスを最適化するコツ
本物のコンテナを使用することでテストの信頼性は飛躍的に向上しますが、実行速度とのトレードオフが発生します。テストスイートの精度を保ちながら高速化を図るための4つのTipsを紹介します。
- ローカル環境で再利用(Reusable Container)を有効化: デフォルトではテストファイルごとに新しいコンテナが作成されます。コンテナ初期化時に
.withReuse()を呼び出し、~/.testcontainers.propertiesにtestcontainers.reuse.enable=trueを設定しましょう。これにより、ローカルでのテスト実行間でコンテナが再利用され、起動待ち時間を約8秒から0.5秒未満に短縮できます。 - 単体テストと統合テストの完全分離: 日付フォーマットやメールアドレスのバリデーションといった純粋なロジックのテストでTestcontainersを起動する必要はありません。
*.integration.test.tsのようにファイルを命名規則で分け、実行コマンドもnpm run test:integrationとして分離することで、日常的なCI実行時間を節約できます。 - CI RunnerにDocker Socketをマウント: GitHub ActionsやGitLab CI上で実行する場合、RunnerがDockerデーモンを制御できる権限が必要です。ジョブ環境に
/var/run/docker.sockが確実にマウントされているか確認してください。 - Alpineベースのイメージを優先: スタンダード版のイメージ(350MB以上)に対し、
postgres:16-alpineは約80MBと非常に軽量です。軽量なベースイメージを採用することで、新規CI Runnerでのイメージプル時間を大幅に削減できます。