背景とマイクロサービスにCircuit Breakerが必要な理由
5つのマイクロサービスが相互に通信するEコマースシステムを例に考えてみましょう。ある時、サードパーティの決済ゲートウェイに障害が発生し、通常なら約150msで返ってくるはずのレスポンスが、タイムアウト直前の30秒まで急増したとします。
この状況で、数千件のユーザーリクエストが一気に押し寄せるとどうなるでしょうか。すべてのリクエストが応答待ちで保留されるため、Node.jsのソケットプールは即座に枯渇し、ファイルディスクリプタの上限に達してしまいます(EMFILEエラー)。メモリ消費量も跳ね上がり、新規リクエストの拒否が多発。最終的には注文(Order)、カート(Cart)、認証(Auth)の各サービスがドミノ倒しのように次々とダウンします。これこそがカスケード障害(Cascading Failure/連鎖的障害)の脅威です。
分散ネットワークにおいて通信の不安定さは避けられません。ダウンストリームのサービスが過負荷に陥っている時、さらにトラフィックを送り続けることは復旧を妨げるだけでなく、呼び出し側のサービスまで道連れにしてしまいます。タイムアウトを2秒に短縮したところで、リクエストの解放がわずかに早くなるだけであり、無駄な数千件のリクエストがネットワークやCPUリソースを浪費し続ける根本的な解決にはなりません。
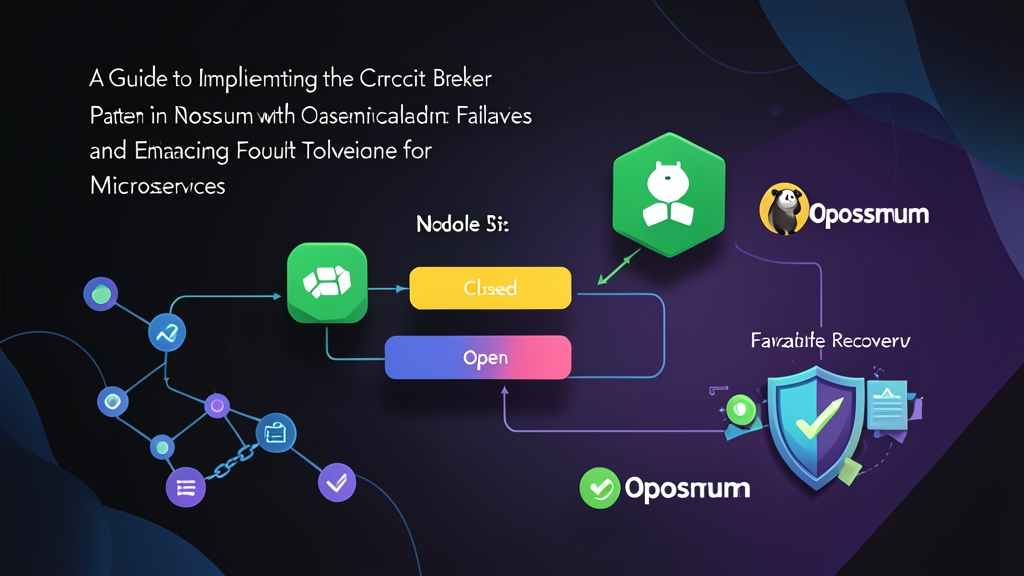
この問題を根本から解決するのがCircuit Breaker Pattern(サーキットブレーカーパターン)です。家庭用ブレーカーが漏電時に回路を遮断して建物全体を守るのと同様に、ソフトウェアのCircuit Breakerは障害が発生しているサービスへの呼び出しを瞬時に遮断します。この仕組みは主に以下の3つのステート(状態)で動作します:
- Closed(遮断解除/通常状態): 正常な状態です。すべてのリクエストが宛先へ通常通り転送されます。失敗率がしきい値(例:50%以上)を超えると、ブレーカーが自動的に作動してOpen状態へ移行します。
- Open(遮断状態): 外部への通信呼び出しを完全に遮断します。到達したリクエストは即座にエラーを返す(fail fast)か、1ms未満で代替処理(fallback)を実行するため、ソケットの待機リソースを一切消費しません。
- Half-Open(半開放状態): あらかじめ設定した休止時間(resetTimeout:通常10〜30秒)が経過すると、テスト目的で少数のリクエストのみ通過させます。これらのリクエストが成功すれば回路は復帰(Closed)し、通常運用に戻ります。逆に失敗した場合は、直ちに再度遮断(Open)されます。
本番運用においては、勘に頼るのではなく実際のトラフィックメトリクスに基づいてパラメータを設計することが不可欠です。誤った設定を行うと、正常に稼働しているサービスまで不必要に遮断してしまうリスクがあります。
Node.jsプロジェクトへのOpossumの導入
Node.jsエコシステムにおいて、opossumは最も実績があり広く使われているCircuit Breakerライブラリです。ネイティブのPromiseやasync/awaitに対応し、軽量なイベント駆動アーキテクチャを採用しており、Prometheusメトリクスとの連携も極めてスムーズです。
プロジェクトを初期化し、opossumとaxiosをインストールします:
mkdir node-circuit-breaker-demo
cd node-circuit-breaker-demo
npm init -y
npm install opossum axios
Opossum Circuit Breakerの詳細設定
ブレーカーを意図通りに動作させるには、各パラメータの意味を正確に把握しておく必要があります。しきい値の設定が過敏すぎると、一時的な軽微な遅延でも誤って遮断が発生してしまいます。逆に緩すぎると、宛先サービスが完全にダウンしているにもかかわらず検知が遅れてしまいます。
以下は、実際の決済API呼び出しをラップした実装モジュールです:
// paymentClient.js
const axios = require('axios');
const CircuitBreaker = require('opossum');

// 実際のAPIリクエストを実行する関数
async function callPaymentGateway(orderData) {
  const response = await axios.post('https://api.payment-mock.com/charge', orderData, {
    timeout: 2500 // 各リクエストのローカルAxiosタイムアウト
  });
  return response.data;
}

// Circuit Breakerの設定
const breakerOptions = {
  timeout: 3000, // 3000msを超えた場合は失敗とみなす
  errorThresholdPercentage: 50, // リクエスト失敗率が50%以上で回路をOpen
  resetTimeout: 10000, // Open状態で10秒間待機してから再試行
  rollingCountTimeout: 10000, // エラー率を算出するための10秒間のスライディングウィンドウ
  rollingCountBuckets: 10, // ウィンドウを10個のバケットに分割(1秒/バケット)
  volumeThreshold: 5 // 遮断判定を行うためにスライディングウィンドウ内で最低限必要なリクエスト数
};

const paymentBreaker = new CircuitBreaker(callPaymentGateway, breakerOptions);

// Fallback: 回路がOpenの場合またはリクエストエラー時にフォールバック結果を返す
paymentBreaker.fallback((orderData, error) => {
  return {
    status: 'DEFERRED',
    message: '決済システムが混雑しているため、注文はバックグラウンド処理キューに追加されました。',
    orderId: orderData.orderId,
    fallback: true
  };
});

module.exports = paymentBreaker;
重要パラメータの解説:
- volumeThreshold: 低トラフィック時における誤検知を防ぎます。例えば深夜3時にリクエストが1件だけ発生してタイムアウトした場合、エラー率は100%(1/1)になってしまいます。最低リクエスト数の下限を設定しておくことで、このような不必要な遮断を防げます。
- rollingCountTimeout: アプリ起動時からの累積値ではなく、リアルタイムのスライディングウィンドウでエラー率を集計します。これにより、30分前に起きた一時的なエラーが現在の遮断判定に悪影響を及ぼすのを防ぎます。
- fallback: グレースフルデグラデーション(緩やかな性能縮退)を実現します。ユーザーに500エラー画面をそのまま返す代わりに、適切な代替メッセージを表示したり、後で再試行するためにジョブをRabbitMQやKafkaへエンキューしたりできます。
Circuit Breakerの状態テストとモニタリング
ブレーカーの挙動を確認するために、Opossumのライフサイクルイベントをリスニングし、宛先エンドポイントの障害をシミュレートしてみましょう。
// server.js
const paymentBreaker = require('./paymentClient');

// 状態を監視するためのイベントリスナーを登録
paymentBreaker.on('open', () => {
  console.warn('⚠️ [CIRCUIT BREAKER] 回路が【OPEN】になりました!外部呼び出しを遮断し、Fallbackを即座に実行します。');
});

paymentBreaker.on('halfOpen', () => {
  console.info('🔄 [CIRCUIT BREAKER] 回路が【HALF-OPEN】に移行しました。ヘルスチェックリクエストを送信中...');
});

paymentBreaker.on('close', () => {
  console.info('✅ [CIRCUIT BREAKER] 回路が【CLOSED】に戻りました。宛先サービスは完全に回復しました。');
});

paymentBreaker.on('fallback', (result) => {
  console.log('🛡️ [FALLBACK TRIGGERED] フォールバック結果を返却しました:', result.orderId);
});

// 応答しないエンドポイントに対して15件の連続リクエストをシミュレート
async function simulateRequests() {
  for (let i = 1; i <= 15; i++) {
    try {
      console.log(`\n--- リクエスト #${i} 送信中 ---`);
      const result = await paymentBreaker.fire({ orderId: `ORDER_${i}`, amount: 100 });
      console.log('結果:', result);
    } catch (err) {
      console.error('リクエスト失敗:', err.message);
    }

    // リクエスト間に800msの間隔を設ける
    await new Promise(resolve => setTimeout(resolve, 800));
  }
}

simulateRequests();
テストを実行します:
node server.js
存在しないモックドメインに対してスクリプトを実行すると、以下のような明確なライフサイクルを確認できます:
- 1件目から5件目のリクエストでは、axiosが2.5秒後にタイムアウトを繰り返します。
- 5件目のリクエストに達した時点で
volumeThresholdの条件を満たし、エラー率が100%に達します。即座にopenイベントが発火します。 - 6件目以降のリクエストでは、Opossumが外部ネットワークへのトラフィックを完全に遮断します。レイテンシほぼ0msでフォールバックデータが即座に返され、Node.jsのソケットとメモリが保護されます。
- 10秒後(resetTimeout経過後)、回路は自動的に
halfOpenへ移行し、ダウンストリームサービスの復旧を確認するためのプローブリクエストを送信します。
本番環境では、prom-clientを使用してOpossumのメトリクスをPrometheusへエクスポートすることをお勧めします。GrafanaダッシュボードやAlertmanager(Slack/Telegram通知)と組み合わせることで、SREチームはエンドユーザーから苦情が寄せられる前にダウンストリームサービスの障害を正確に察知できるようになります。