午前2時、データベースが停止し、アラートが鳴り響く
これは私の実体験だ。レスポンスタイムが200msから8秒に跳ね上がり、データベースのCPUは100%に達し、その時に頭に浮かんだのはただ一つ:「なぜこれをキャッシュしていなかったのか?」という後悔だった。
問題はキャッシュがなかったわけではない——Redisはすでに使っていた。しかし毎回のリクエストがネットワーク越しにRedisを呼び出しており、データがそのプロセスのメモリ内に収まるはずなのに無駄なレイテンシが発生していた。マルチレベルキャッシングは、1年早く知っておきたかった技術だ。
クイックスタート:5分で動かす
必要な2つのパッケージをインストールする:
npm install ioredis node-cache2層キャッシュを持つcache-manager.jsファイルを作成する:
const NodeCache = require('node-cache');
const Redis = require('ioredis');

const L1 = new NodeCache({ stdTTL: 60, checkperiod: 120 }); // In-memory, TTL 60s
const L2 = new Redis({ host: 'localhost', port: 6379 });

async function get(key) {
  // 第1層:In-memoryキャッシュ(〜0.01ms)
  const l1Hit = L1.get(key);
  if (l1Hit !== undefined) return l1Hit;

  // 第2層:Redis(〜1ms)
  const l2Hit = await L2.get(key);
  if (l2Hit) {
    const parsed = JSON.parse(l2Hit);
    L1.set(key, parsed); // 次のリクエストのためにL1にバックフィル
    return parsed;
  }

  return null;
}

async function set(key, value, ttl = 300) {
  L1.set(key, value, 60);                           // L1: 60s
  await L2.setex(key, ttl, JSON.stringify(value));  // L2: 300s
}

async function del(key) {
  L1.del(key);
  await L2.del(key);
}

module.exports = { get, set, del };
ルートハンドラーで即座に使う:
const cache = require('./cache-manager');

app.get('/products/:id', async (req, res) => {
  const key = `product:${req.params.id}`;

  let product = await cache.get(key);
  if (!product) {
    product = await db.query('SELECT * FROM products WHERE id = ?', [req.params.id]);
    await cache.set(key, product, 600); // 10分間キャッシュ
  }

  res.json(product);
});
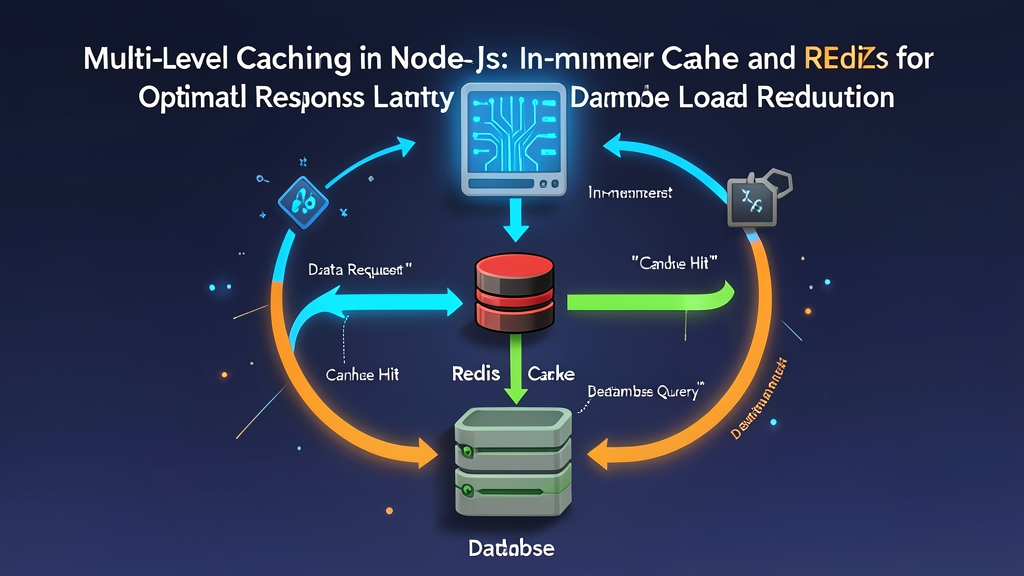
以上だ。最初のリクエストはDBにヒットし、次回はRedis(L2)から返り、その次はin-memory(L1)から直接返る——ネットワークもディスクも不要だ。
なぜ2層が必要なのか?
Redisだけでは不十分
Redisは非常に高速だが、依然としてネットワーク呼び出しだ。同一データセンター内でも、Redis呼び出し1回あたり約0.5〜2msかかる。小さく聞こえるが、APIハンドラーがRedisを10回呼び出せば、1リクエストあたり5〜20msの「無駄な」時間が発生する——Redisが過負荷になったりネットワークの瞬断が起きた場合は言わずもがなだ。
In-memoryキャッシュ(L1)はNode.jsのプロセス内に存在する:アクセスに要する時間は0.01〜0.1msで、10〜100倍高速だ。数十秒間に繰り返し読み取られるデータ?L1からほぼ即座に返ってくる。
In-memoryだけでも問題がある
In-memoryキャッシュはプロセスのRAMに制限され、水平スケール時に複数インスタンス間で共有できず、再起動時にすべて消える。Redisはこの3つの問題を解決する。両方を組み合わせて初めて十分となる。
高度な実装
正しいキャッシュ無効化——後回しにしてはいけない
データベースを更新済みなのに商品価格が間違った値のまま表示される原因を2時間デバッグしたことがある——犯人はTTLが55秒残っていたL1キャッシュだった。その経験から学んだこと:invalidation戦略はビジネスロジックを書く前に定義すべきで、すべてが燃え崩れた後ではない。
// KEYSの代わりにRedis SCANを使う——本番環境で安全
async function invalidateByPattern(pattern) {
  // L1を削除
  const l1Keys = L1.keys().filter(k => k.startsWith(pattern));
  l1Keys.forEach(k => L1.del(k));

  // SCANでL2を削除(KEYSと違いRedisをブロックしない)
  let cursor = '0';
  do {
    const [nextCursor, keys] = await L2.scan(cursor, 'MATCH', `${pattern}*`, 'COUNT', 100);
    cursor = nextCursor;
    if (keys.length > 0) await L2.del(...keys);
  } while (cursor !== '0');
}

// データ更新時に呼び出す
app.put('/products/:id', async (req, res) => {
  await db.query('UPDATE products SET ? WHERE id = ?', [req.body, req.params.id]);
  await invalidateByPattern(`product:${req.params.id}`);
  res.json({ success: true });
});
Redis障害時のサーキットブレーカー
Redisも時には障害が起きる。フォールバックがなければ、アプリも一緒にダウンする:
let redisAvailable = true;
L2.on('error', () => { redisAvailable = false; });
L2.on('connect', () => { redisAvailable = true; });

async function get(key) {
  const l1Hit = L1.get(key);
  if (l1Hit !== undefined) return l1Hit;

  if (!redisAvailable) return null; // ダウン中はRedisをスキップ

  try {
    const l2Hit = await Promise.race([
      L2.get(key),
      new Promise((_, reject) => setTimeout(() => reject(new Error('timeout')), 100))
    ]);
    if (l2Hit) {
      const parsed = JSON.parse(l2Hit);
      L1.set(key, parsed);
      return parsed;
    }
  } catch (err) {
    console.error('Redis error, fallback to DB:', err.message);
  }
  return null;
}
mutexによるキャッシュスタンピードの防止
再起動後、L1は完全に空になる。トラフィックが500 req/sでL1ミスが同時に発生すると、500件のDBクエリが一気に走る——健全なデータベースでさえ数秒でクラッシュさせるには十分だ。これをthundering herdと呼ぶ。解決策はin-processのmutexを使うことだ:
const pending = new Map();

async function getWithMutex(key, fetchFn, ttl = 300) {
  const cached = await cache.get(key);
  if (cached) return cached;

  // このキーに対して処理中のpromiseがあれば待機する
  if (pending.has(key)) return pending.get(key);

  const promise = fetchFn()
    .then(async data => {
      await cache.set(key, data, ttl);
      pending.delete(key);
      return data;
    })
    .catch(err => { pending.delete(key); throw err; });

  pending.set(key, promise);
  return promise;
}
本番環境から学んだ実践的なTips
1. L1のTTLはL2のTTLより短くする
L1はインスタンス間で共有されないため、TTLが長いとNode.jsの各インスタンスが異なるデータを返すことになる。安全な比率:L1のTTL = L2のTTLの1/5〜1/10。例:L1 30秒、L2 300秒——それだけだ。
2. ヒット率を監視する——80%を下回ったら見直しが必要
let stats = { l1Hit: 0, l2Hit: 0, miss: 0 };

// get()関数の各分岐に組み込む
// ...

app.get('/health/cache', (req, res) => {
  const total = stats.l1Hit + stats.l2Hit + stats.miss;
  res.json({
    ...stats,
    hitRate: total > 0 ? ((stats.l1Hit + stats.l2Hit) / total * 100).toFixed(1) + '%' : 'N/A'
  });
});
3. キー命名規則:entity:id:variant形式を使う
例:product:123:detail、user:456:profile、category:electronics:list:page2。最初から一貫した命名規則を守れば、後でstaleデータのバグをデバッグする際の頭痛が大幅に減る。
4. すべてをキャッシュしてはいけない
キャッシュはヒット率が高い場合にのみ効果がある。キャッシュすべきもの:頻繁に読まれる、変更が少ない、生成にリソースがかかるデータ。キャッシュすべきでないもの:口座残高、リアルタイムの注文状態、秒単位の高いconsistencyが求められるあらゆるもの。
次に午前2時にアラートが鳴っても、あなたにはすでにL1 + L2キャッシュが実装済みであることを願っている——昔の自分のように、その瞬間に慌てて実装を始めるのではなく。