Vấn đề muôn thuở: Khi bảng dữ liệu chạm ngưỡng chục triệu dòng
Hãy tưởng tượng bạn quản lý một kho tài liệu giấy. Bạn nhét 10 triệu bản hợp đồng vào chung một phòng và không dán nhãn. Mỗi lần sếp hỏi hợp đồng năm 2021, bạn phải lật từng kệ để tìm. Ngược lại, nếu bạn chia phòng thành từng tủ riêng theo từng năm, bạn chỉ mất vài giây đi thẳng tới tủ 2021.
Database MySQL cũng vận hành y hệt như vậy.
Khi bảng users chạm mốc 10 triệu dòng, bạn vẫn có thể sống sót nhờ tối ưu B-Tree Index. Nhưng với các bảng đơn hàng (orders), log hệ thống hay dữ liệu IoT chạm mốc 50 – 100 triệu dòng, index bắt đầu phản tác dụng. Dung lượng dữ liệu lẫn index vượt xa bộ nhớ đệm InnoDB Buffer Pool (thường chỉ 16GB hoặc 32GB RAM trên server). Ổ cứng NVMe bắt đầu đọc ghi liên tục. Query nghẽn hàng đợi.
Đau đầu nhất là khâu dọn dẹp dữ liệu cũ. Lệnh DELETE FROM logs WHERE created_at < '2023-01-01' trên bảng 50 triệu dòng sẽ phình to undo log, khóa hàng loạt bản ghi và làm nghẽn I/O. Ứng dụng có thể treo cứng cả tiếng. Table Partitioning sinh ra để giải quyết đúng bài toán này.
Table Partitioning là gì?
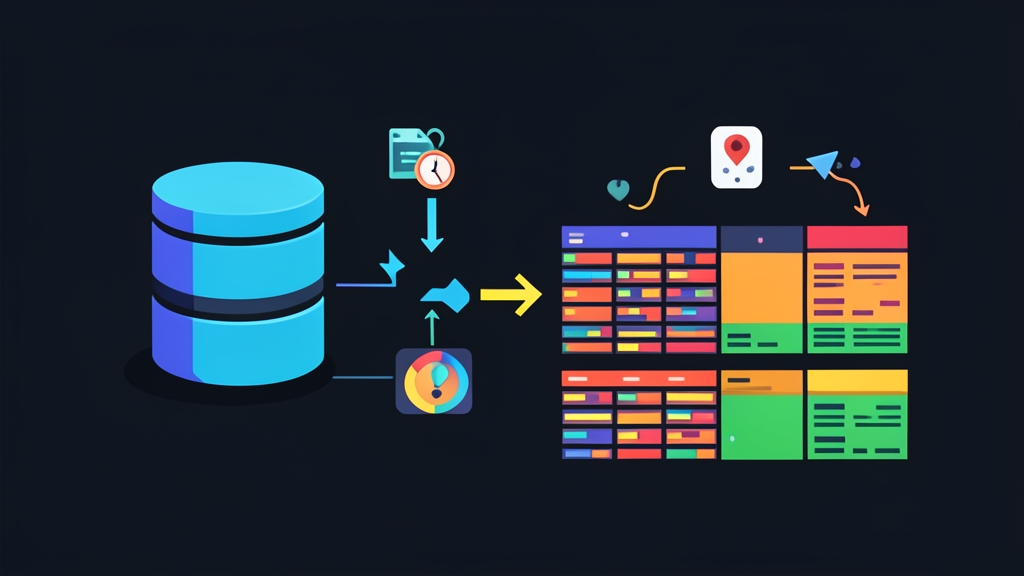
Hiểu đơn giản, Table Partitioning (Phân vùng bảng) chia nhỏ một bảng khổng lồ thành nhiều phần độc lập trên ổ cứng (mỗi phân vùng là một file .ibd riêng trong InnoDB). Dù vậy, ứng dụng backend vẫn chỉ nhìn thấy một bảng duy nhất.
Bạn không cần đổi code hay tự tách thành orders_2022, orders_2023 rồi dùng UNION. Câu query của bạn giữ nguyên:
SELECT * FROM orders WHERE order_date = '2024-05-10';Lúc này, bộ tối ưu hóa của MySQL kích hoạt cơ chế Partition Pruning (Cắt tỉa phân vùng). MySQL đọc điều kiện WHERE, định vị chính xác phân vùng năm 2024 và bỏ qua toàn bộ phần còn lại. Thay vì quét 100 triệu dòng, MySQL chỉ cần rà soát 6 triệu dòng của riêng năm 2024. Tốc độ cải thiện rõ rệt.
Hai kiểu phân vùng phổ biến nhất
- RANGE Partitioning: Chia theo dải giá trị liên tục. Phổ biến nhất là chia theo mốc thời gian (năm, quý, tháng) hoặc dải ID tự tăng (từ 1 đến 1.000.000).
- LIST Partitioning: Chia theo danh sách giá trị rời rạc xác định trước. Ví dụ: mã phân vùng địa lý (Miền Bắc: 1, Miền Trung: 2, Miền Nam: 3) hoặc trạng thái đơn hàng.
Quy tắc kỹ thuật bất di bất dịch: Mọi khóa duy nhất (Primary Key hoặc Unique Key) trên bảng bắt buộc phải chứa cả cột phân vùng. Nếu bảng có khóa chính là id mà bạn partition theo order_date, MySQL sẽ từ chối tạo bảng ngay lập tức.
Thực hành: Cấu hình RANGE và LIST Partitioning
1. Phân vùng theo khoảng thời gian (RANGE)
Giả sử ta thiết kế bảng orders lưu trữ 80 triệu đơn hàng thương mại điện tử, mỗi năm phát sinh khoảng 20 triệu bản ghi:
CREATE TABLE orders (
    id BIGINT NOT NULL AUTO_INCREMENT,
    customer_id INT NOT NULL,
    order_amount DECIMAL(10, 2) NOT NULL,
    order_date DATE NOT NULL,
    PRIMARY KEY (id, order_date)
)
ENGINE=InnoDB
PARTITION BY RANGE (YEAR(order_date)) (
    PARTITION p2022 VALUES LESS THAN (2023),
    PARTITION p2023 VALUES LESS THAN (2024),
    PARTITION p2024 VALUES LESS THAN (2025),
    PARTITION p_future VALUES LESS THAN MAXVALUE
);
Điểm mấu chốt trong cấu hình trên:
p2022hứng dữ liệu từ năm 2022 trở về trước.p2023vàp2024chứa dữ liệu của từng năm tương ứng.p_futurevới mệnh đềMAXVALUEđóng vai trò chốt chặn. Nếu thiếu nó, một đơn hàng phát sinh vào năm 2025 sẽ khiến MySQL trả lỗi “Table has no partition for value 2025” và từ chối ghi.
Hãy chạy thử EXPLAIN để kiểm chứng cơ chế Partition Pruning:
EXPLAIN SELECT * FROM orders WHERE order_date BETWEEN '2023-03-01' AND '2023-06-30';Nhìn vào cột partitions trong kết quả, bạn sẽ thấy xuất hiện duy nhất p2023. MySQL đã gạt bỏ 3 phân vùng còn lại ra khỏi bộ nhớ.
Lợi ích lớn nhất: Dọn dẹp dữ liệu cũ tức thì. Sau 3 năm, bạn cần xóa toàn bộ dữ liệu năm 2022 để lấy lại 30GB dung lượng đĩa. Thay vì chạy DELETE làm nghẽn hệ thống, bạn chỉ cần gõ một lệnh:
ALTER TABLE orders DROP PARTITION p2022;Lệnh này xóa thẳng file vật lý trên ổ đĩa. Quá trình hoàn tất sau chưa đầy 0.05 giây, giải phóng dung lượng ngay lập tức mà không sinh undo log hay lock bảng.
2. Phân vùng theo nhóm giá trị rời rạc (LIST)
Xét trường hợp bạn xây dựng bảng doanh số store_sales với các chi nhánh chia theo 3 vùng: Miền Bắc (ID vùng: 1, 2), Miền Trung (3, 4) và Miền Nam (5, 6):
CREATE TABLE store_sales (
    id BIGINT NOT NULL AUTO_INCREMENT,
    branch_id INT NOT NULL,
    region_id INT NOT NULL,
    revenue DECIMAL(12, 2) NOT NULL,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    PRIMARY KEY (id, region_id)
)
ENGINE=InnoDB
PARTITION BY LIST (region_id) (
    PARTITION p_north VALUES IN (1, 2),
    PARTITION p_central VALUES IN (3, 4),
    PARTITION p_south VALUES IN (5, 6)
);
Khi kế toán lọc số liệu cho các chi nhánh phía Bắc:
EXPLAIN SELECT * FROM store_sales WHERE region_id IN (1, 2);MySQL điều hướng query quét thẳng vào file p_north, cắt giảm ngay 66% khối lượng dữ liệu phải kiểm tra.
Sau này, nếu công ty mở rộng chi nhánh lên Tây Nguyên (mã 7, 8), bạn chỉ cần bổ sung phân vùng mới:
ALTER TABLE store_sales ADD PARTITION (
    PARTITION p_highlands VALUES IN (7, 8)
);
Khi nào nên và không nên dùng Table Partitioning?
Partitioning giải quyết bài toán bảng lớn rất tốt, nhưng nó không phải liều thuốc trị bách bệnh. Bạn chỉ nên dùng khi:
- Bảng thực sự lớn: Dung lượng bảng vượt quá 20 triệu dòng, hoặc kích thước file dữ liệu lớn hơn dung lượng RAM của database server.
- Cần xóa dữ liệu theo chu kỳ: Hệ thống log, audit trail hoặc đơn hàng cũ cần xóa định kỳ theo tháng/năm.
- Query luôn lọc theo cột phân vùng: Đa số các câu truy vấn quan trọng đều chứa điều kiện
WHEREbám chặt vào partition key.
Ngược lại, đừng dùng partitioning cho các bảng nhỏ dưới 5 triệu dòng. Chi phí quản lý metadata của MySQL sẽ làm query chạy chậm hơn bảng thông thường.
Đặc biệt nguy hiểm: Nếu ứng dụng chạy một câu query mà không truyền cột phân vùng trong WHERE, MySQL buộc phải quét toàn bộ các phân vùng (scatter-gather query). Thao tác này tiêu tốn CPU và I/O khủng khiếp, phản tác dụng hoàn toàn so với thiết kế ban đầu.