Quick Start: Chạy thử Cache-Aside trong 5 phút
Đĩa cứng luôn là nút thắt cổ chai chậm nhất. Khi lượng truy cập tăng vọt từ 200 lên 5.000 req/s, MySQL thường kiệt sức vì nghẽn I/O. Kéo dữ liệu từ RAM của Redis chỉ tốn khoảng 0.5ms – 1.5ms, trong khi truy vấn qua ổ đĩa SSD NVMe vẫn ngốn 15ms – 50ms.
Dưới đây là môi trường thử nghiệm nhanh bằng Docker:
# 1. Khởi chạy MySQL và Redis container
docker run -d --name mysql-demo -e MYSQL_ROOT_PASSWORD=secret -e MYSQL_DATABASE=shop -p 3306:3306 mysql:8.0
docker run -d --name redis-demo -p 6379:6379 redis:7-alpine

# 2. Cài đặt thư viện kết nối Python
pip install mysql-connector-python redis
Đoạn mã Python triển khai luồng Cache-Aside cơ bản (đọc cache trước, trượt thì query DB rồi lưu lại vào Redis):
import json
import redis
import mysql.connector

r = redis.Redis(host='localhost', port=6379, db=0, decode_responses=True)
db = mysql.connector.connect(
    host='localhost',
    user='root',
    password='secret',
    database='shop'
)

def get_product(product_id: int):
    cache_key = f"product:{product_id}"

    # 1. Kiểm tra cache trong Redis
    cached_data = r.get(cache_key)
    if cached_data:
        return json.loads(cached_data)  # Cache HIT (~1ms)

    # 2. Cache MISS: Truy vấn trực tiếp từ MySQL (~25ms)
    cursor = db.cursor(dictionary=True)
    cursor.execute("SELECT id, name, price, stock FROM products WHERE id = %s", (product_id,))
    product = cursor.fetchone()
    cursor.close()

    # 3. Nạp dữ liệu vào Redis kèm TTL (5 phút)
    if product:
        r.setex(cache_key, 300, json.dumps(product))

    return product
Bản chất vận hành của Cache-Aside Pattern
Áp lực thực tế lên MySQL khi thiếu tầng Cache
Trên hệ thống thương mại điện tử với database MySQL ~60GB, mỗi trang chi tiết sản phẩm đòi hỏi join từ 3-4 bảng. MySQL phải phân tích cú pháp SQL, duyệt cây chỉ mục B-Tree và nạp page vào InnoDB Buffer Pool.
Vào đợt flash sale, hàng nghìn người cùng xem một sản phẩm ‘hot’. CPU MySQL lập tức chạm mốc 100%. Disk IOPS cạn kiệt khiến connection pool đạt ngưỡng max_connections=500. Toàn bộ API bắt đầu trả về mã lỗi 504 Gateway Timeout.
Hai luồng dữ liệu độc lập
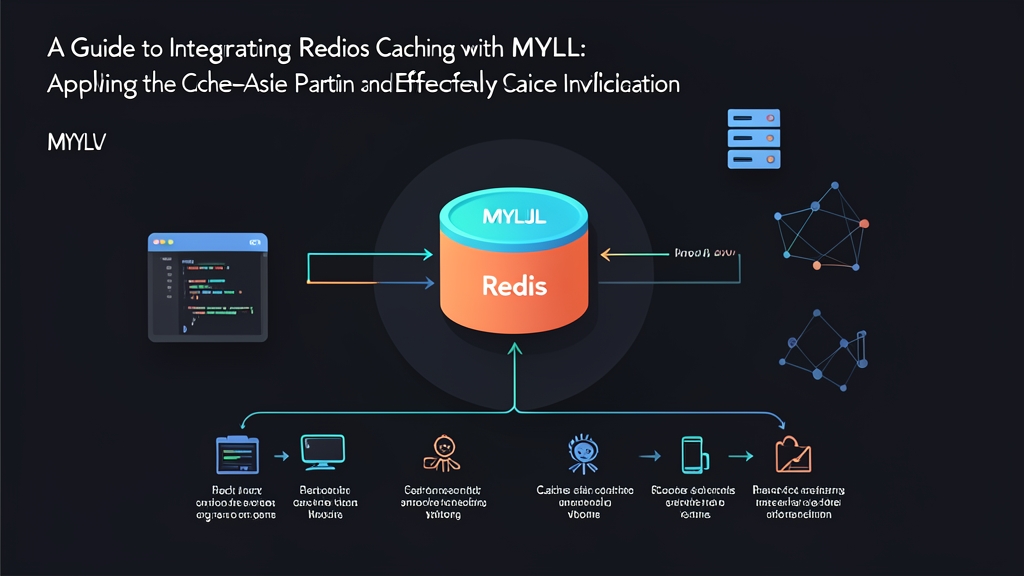
Ở mô hình Cache-Aside, tầng ứng dụng trực tiếp điều phối cả cache lẫn database:
- Luồng đọc (Read Path): App tìm trên Redis trước. Nếu có (Hit), app trả dữ liệu ngay với latency dưới 1ms. Nếu không thấy (Miss), app truy vấn MySQL, trả kết quả cho client rồi set ngược vào Redis kèm thời gian sống (TTL).
- Luồng ghi (Write Path): Khi phát sinh INSERT, UPDATE hoặc DELETE, app cập nhật thẳng vào MySQL. Ngay sau đó, app xóa bỏ key tương ứng trên Redis thay vì sửa giá trị.
Xử lý bài toán Cache Invalidation
Khó khăn lớn nhất khi làm việc với cache là giữ dữ liệu đồng bộ. Một sơ suất nhỏ sẽ khiến khách hàng nhìn thấy giá cũ hoặc số lượng tồn kho sai lệch.
Vì sao nên Xóa cache thay vì Cập nhật cache?
Nhiều lập trình viên có thói quen: sửa DB xong liền gọi r.set() giá trị mới vào Redis. Thao tác này rất dễ dính Race Condition khi hai request ghi diễn ra song song:
- Tiến trình A ghi giá trị
price = 100vào MySQL. - Tiến trình B ghi tiếp giá trị
price = 120vào MySQL. - Do nghẽn mạng, tiến trình B cập nhật Redis trước (set 120). Sau đó vài mili-giây, tiến trình A mới ghi đè vào Redis (set 100).
- Hậu quả: MySQL lưu 120 (mới nhất), nhưng Redis lại kẹt ở 100 (cũ). Người dùng sẽ liên tục nhìn thấy giá sai cho đến khi key hết hạn.
Quy tắc bất di bất dịch: Hãy xóa key (Evict/Delete) khỏi Redis sau khi commit database thành công.
def update_product_price(product_id: int, new_price: float):
    cursor = db.cursor()
    # 1. Cập nhật và commit vào MySQL trước
    cursor.execute("UPDATE products SET price = %s WHERE id = %s", (new_price, product_id))
    db.commit()
    cursor.close()

    # 2. Xóa bỏ key để lần đọc sau buộc phải kéo dữ liệu mới từ DB
    cache_key = f"product:{product_id}"
    r.delete(cache_key)
Giải quyết Replication Lag bằng Delayed Double Deletion
Mô hình MySQL Master-Slave (Read/Write Split) tiềm ẩn một rủi ro khác: độ trễ đồng bộ (Replication Lag). Giả sử slave trễ 100ms so với master:
- Luồng ghi cập nhật Master và xóa cache Redis.
- Đúng lúc này, luồng đọc nhận Cache Miss, bèn nhảy vào Slave truy vấn.
- Vì Slave chưa kịp sync, luồng đọc bốc trúng dữ liệu cũ và set ngược vào Redis. Dữ liệu sai lại tiếp tục tồn tại.
Kỹ thuật Delayed Double Deletion khắc phục triệt để kịch bản này bằng cách xóa cache lần hai sau một quãng nghỉ ngắn:
import time
import threading

def async_delayed_delete(key: str, delay_seconds: float = 0.5):
    time.sleep(delay_seconds)
    try:
        r.delete(key)
    except Exception as e:
        # Ghi log hoặc đẩy vào retry queue (RabbitMQ/Kafka) nếu Redis lỗi
        print(f"Retry delete failed: {e}")

def update_product_safe(product_id: int, new_price: float):
    cache_key = f"product:{product_id}"

    # 1. Xóa cache lần 1
    r.delete(cache_key)

    # 2. Cập nhật Master DB
    cursor = db.cursor()
    cursor.execute("UPDATE products SET price = %s WHERE id = %s", (new_price, product_id))
    db.commit()
    cursor.close()

    # 3. Chờ Slave đồng bộ xong rồi xóa lần 2 (chạy background thread hoặc Celery/Kafka)
    threading.Thread(target=async_delayed_delete, args=(cache_key, 0.5)).start()
Kinh nghiệm vận hành Production
- Bắt buộc cấu hình TTL kèm Jitter: Đừng bao giờ dùng lệnh
SETkhông có hạn lưu trữ. Hãy luôn dùngSETEX. Để tránh lỗi Cache Stampede khi hàng trăm key cùng hết hạn một giây, hãy thêm độ lệch ngẫu nhiên:ttl = 300 + random.randint(5, 60). - Cấu hình Maxmemory Policy: Bộ nhớ RAM có hạn. Khi Redis đầy 90% dung lượng, cấu hình
maxmemory-policy allkeys-lruhoặcvolatile-lrutrongredis.confsẽ tự động trục xuất các key ít dùng nhất, ngăn tiến trình Redis bị hệ điều hành OOM Killer tiêu diệt. - Lựa chọn định dạng lưu trữ: Với dữ liệu hiển thị cả trang, serialize thành chuỗi JSON nén qua
SETEXđem lại tốc độ cao nhất. Nếu cần sửa thường xuyên từng trường nhỏ lẻ như số tồn kho, cấu trúcHSET/HINCRBYsẽ tiết kiệm băng thông và tối ưu I/O hơn nhiều.