Quick Start: 5分で試すCache-Aside実践
ディスクI/Oはシステムにおいて常に最大のボトルネックです。トラフィックが200から5,000 req/sへと急増すると、MySQLはI/Oの枯渇により深刻なリソース不足に陥ります。RedisのRAMからデータを取得する際のレイテンシは約0.5ms〜1.5ms程度ですが、NVMe SSDを介したデータベースクエリであっても15ms〜50ms程度を消費します。
以下は、Dockerを用いた簡単な検証環境の構築手順です:
# 1. MySQLおよびRedisコンテナの起動
docker run -d --name mysql-demo -e MYSQL_ROOT_PASSWORD=secret -e MYSQL_DATABASE=shop -p 3306:3306 mysql:8.0
docker run -d --name redis-demo -p 6379:6379 redis:7-alpine

# 2. Python接続ライブラリのインストール
pip install mysql-connector-python redis
基本的なCache-Asideフロー(キャッシュを先に読み込み、ミス時はDBへクエリを発行してRedisに書き戻す)を実装したPythonコード:
import json
import redis
import mysql.connector

r = redis.Redis(host='localhost', port=6379, db=0, decode_responses=True)
db = mysql.connector.connect(
    host='localhost',
    user='root',
    password='secret',
    database='shop'
)

def get_product(product_id: int):
    cache_key = f"product:{product_id}"

    # 1. Redisキャッシュの存在確認
    cached_data = r.get(cache_key)
    if cached_data:
        return json.loads(cached_data)  # キャッシュHIT(約1ms)

    # 2. キャッシュMISS: MySQLから直接クエリ(約25ms)
    cursor = db.cursor(dictionary=True)
    cursor.execute("SELECT id, name, price, stock FROM products WHERE id = %s", (product_id,))
    product = cursor.fetchone()
    cursor.close()

    # 3. TTL(5分)を設定してRedisにデータをキャッシュ
    if product:
        r.setex(cache_key, 300, json.dumps(product))

    return product
Cache-Asideパターンの基本構造と動作原理
キャッシュ層が存在しない場合のMySQLの負荷
約60GB規模のMySQLデータベースを抱えるECサイトでは、商品詳細ページの表示ごとに3〜4テーブルのJOIN処理が走ることも珍しくありません。MySQLはSQLの構文解析を行い、B-Treeインデックスツリーを走査し、InnoDB Buffer Poolにページをロードする必要があります。
タイムセール時に多数のユーザーが特定の一斉注目商品に殺到すると、MySQLのCPU使用率は瞬時に100%に達します。ディスクIOPSが枯渇することでコネクションプールがmax_connections=500の上限に達し、最終的にAPI全体が504 Gateway Timeoutを返し始める事態に陥ります。
2つの独立したデータフロー
Cache-Asideモデルでは、アプリケーション層がキャッシュとデータベースの双方を直接オーケストレーションします:
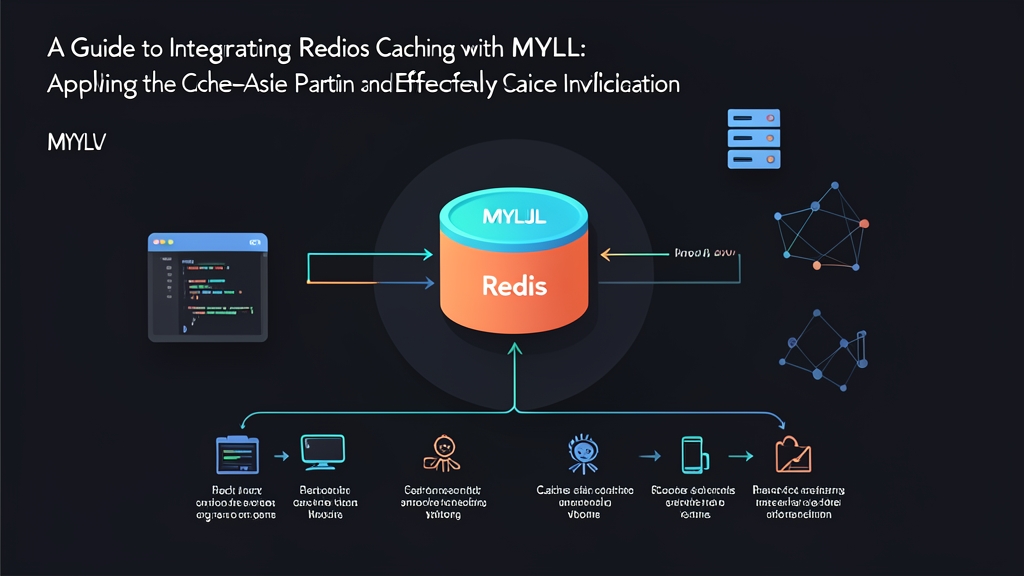
- 読み込みパス(Read Path): アプリケーションはまずRedisを参照します。データが存在する場合(Hit)、1ms未満の低レイテンシで即座に応答します。存在しない場合(Miss)、MySQLへ問い合わせを行い、クライアントへ結果を返却すると同時にTTLを設定してRedisへキャッシュを保存します。
- 書き込みパス(Write Path): INSERT、UPDATE、DELETEが発生した場合、アプリケーションはまずMySQLに直接更新をかけます。その後、Redisの該当キーの値を更新するのではなく、キー自体を削除します。
Cache Invalidation(キャッシュ無効化)の課題解決
キャッシュ運用における最大の難所は、データの一貫性をいかに保つかという点です。わずかな考慮漏れによって、古い価格が表示されたり、不正確な在庫数が表示されたりといった不整合が発生します。
キャッシュの更新ではなく「削除」を選択すべき理由
データベースを更新した直後、新しい値をr.set()でRedisに上書きしてしまう実装が散見されます。しかしこの操作は、複数の書き込みリクエストが並行して実行された際にRace Condition(競合状態)を引き起こす危険性があります:
- プロセスAがMySQLに
price = 100を書き込む。 - プロセスBが続いてMySQLに
price = 120を書き込む。 - ネットワークの遅延などの影響で、プロセスBが先にRedisを更新(120を設定)し、その数ミリ秒後にプロセスAがRedisを古い値で上書き(100を設定)してしまう。
- 結果: MySQLには最新の120が保存されているにもかかわらず、Redisには古い100が残存します。キーの有効期限が切れるまで、ユーザーには誤った価格が表示され続けることになります。
鉄則: データベースのコミットが正常に完了した後は、Redisの値を直接変更せず、キーを明示的に削除(Evict/Delete)してください。
def update_product_price(product_id: int, new_price: float):
    cursor = db.cursor()
    # 1. 先にMySQLを更新してコミット
    cursor.execute("UPDATE products SET price = %s WHERE id = %s", (new_price, product_id))
    db.commit()
    cursor.close()

    # 2. 次回読み込み時にDBから最新データをフェッチさせるためキーを削除
    cache_key = f"product:{product_id}"
    r.delete(cache_key)
Delayed Double Deletionによるレプリケーション遅延の解消
MySQLのMaster-Slave構成(リード/ライト分離)を採用している場合、レプリケーション遅延(Replication Lag)という別のリスクが伴います。例えば、SlaveがMasterに対して100ms遅延している状況を考えます:
- 書き込みプロセスがMasterを更新し、Redisのキャッシュを削除する。
- まさにそのタイミングで読み込みプロセスがCache Missを検知し、Slaveへクエリを発行する。
- Slaveにはまだ同期が追いついていないため、読み込みプロセスは古いデータを取得し、それをRedisに書き戻してしまう。その結果、不整合データが再びキャッシュとして定着する。
Delayed Double Deletion(遅延二重削除)テクニックは、わずかな待機時間を挟んで2度目のキャッシュ削除を行うことで、この不整合シナリオを確実に防ぎます:
import time
import threading

def async_delayed_delete(key: str, delay_seconds: float = 0.5):
    time.sleep(delay_seconds)
    try:
        r.delete(key)
    except Exception as e:
        # Redisエラー時はログ記録またはリトライキュー(RabbitMQ/Kafka)へ転送
        print(f"Retry delete failed: {e}")

def update_product_safe(product_id: int, new_price: float):
    cache_key = f"product:{product_id}"

    # 1. 1回目のキャッシュ削除
    r.delete(cache_key)

    # 2. Master DBの更新
    cursor = db.cursor()
    cursor.execute("UPDATE products SET price = %s WHERE id = %s", (new_price, product_id))
    db.commit()
    cursor.close()

    # 3. Slaveのレプリケーション完了を待ってから2回目の削除(バックグラウンドスレッドまたはCelery/Kafkaで実行)
    threading.Thread(target=async_delayed_delete, args=(cache_key, 0.5)).start()
本番環境における運用のベストプラクティス
- TTLへのジッター(Jitter)付与の徹底: 有効期限を設定しない素の
SETコマンドは決して使わず、常にSETEXを使用してください。数百件のキーが同一秒に一斉失効してCache Stampedeが発生するのを防ぐため、ランダムな揺らぎを加えます:ttl = 300 + random.randint(5, 60)。 - Maxmemory Policyの適切な設定: 物理RAMの容量には上限があります。Redisのメモリ使用量が上限の90%に達した際、
redis.confでmaxmemory-policy allkeys-lruまたはvolatile-lruを設定しておくことで、最も使われていないキーから自動的に退避(Evict)させ、OSのOOM Killerによるプロセス強制終了を回避できます。 - 適切なデータ構造の選定: ページ全体の表示データであれば、圧縮したJSON文字列として
SETEXで保存するのが最も高速です。一方で在庫数などの細かな特定フィールドのみを頻繁に更新する場合は、HSETやHINCRBYといったハッシュ構造を活用する方が、ネットワーク帯域の節約とI/O効率化の面で遥かに優れています。