背景と実践における課題
ECサイト、コミュニティフォーラム、人事管理システムなどを開発していると、遅かれ早かれ階層型データ(木構造データ)を扱うことになります。しかし厄介なのは、リレーショナルデータベース(RDBMS)が本質的にフラットな2次元テーブルを管理するために作られているのに対し、木構造は自由に分岐し何階層にもネストする点です。
設計初期にモデルの選択を誤ると、典型的な2つのトラブルに見舞われます。軽微な場合でも、多階層メニューを1つレンダリングするだけで何十回ものN+1クエリが発行されます。深刻なケースでは、管理者が親カテゴリをドラッグ&ドロップで移動した瞬間にデータベースでデッドロックが発生し、CPU使用率が100%に跳ね上がります。MySQLやPostgreSQLにおいて、選択したテーブル構造は、データが数十万件規模に達した際にシステムが快適に稼働し続けるか、あるいはクラッシュするかを決定づける要因となります。
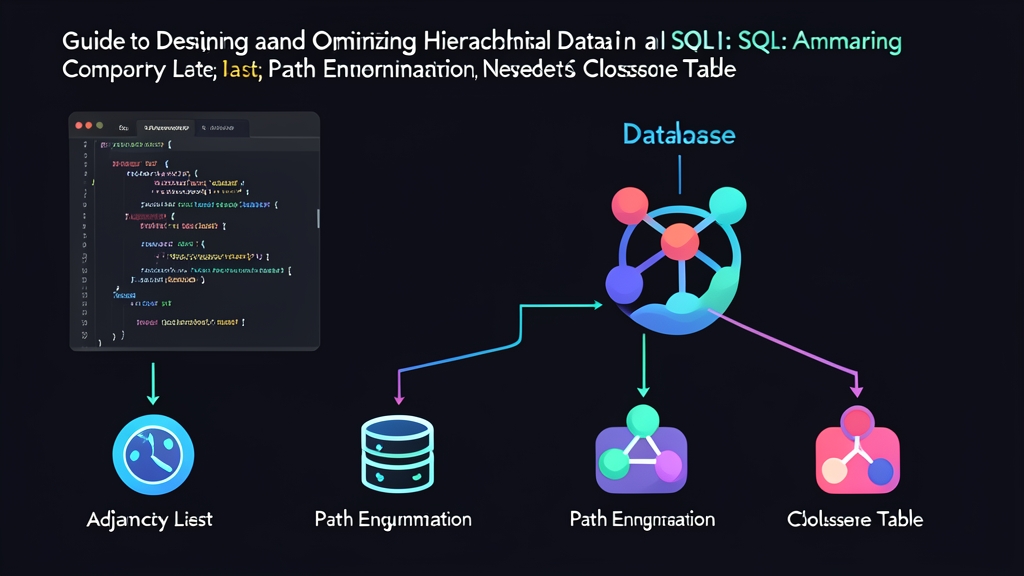
現在、主流となっているアプローチは主に4つあります。隣接リスト(Adjacency List)、経路列挙(Path Enumeration / Materialized Path)、入れ子集合(Nested Sets)、そして閉包テーブル(Closure Table)です。あらゆる要件を満たす万能な解決策は存在しません。本質的には、読み込み速度(Read)を優先するか、それとも書き込み・更新コスト(Write)の低さを優先するかのトレードオフです。
サンプルスキーマの構築
比較しやすいように、テクノロジー製品のカテゴリツリーを共通のサンプルとして構築します:家電・電子機器 > スマートフォン > iOS / Android および 家電・電子機器 > ノートPC。
1. Adjacency List(隣接リスト)
最も直感的で馴染みのあるアプローチです。各レコードに親ノードの主キーを直接指し示すparent_idカラムを1つ追加するだけで構成できます。
CREATE TABLE categories_adj (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    parent_id INT NULL,
    CONSTRAINT fk_parent FOREIGN KEY (parent_id) REFERENCES categories_adj(id) ON DELETE CASCADE,
    INDEX idx_parent (parent_id)
);

INSERT INTO categories_adj (id, name, parent_id) VALUES
(1, '家電・電子機器', NULL),
(2, 'スマートフォン', 1),
(3, 'ノートPC', 1),
(4, 'iOS', 2),
(5, 'Android', 2);
2. Path Enumeration(経路列挙 – Materialized Path)
Unixのディレクトリパス構造(例: /var/log/nginx/)から着想を得た手法です。各ノードがルートから自身に至るまでの完全な経路文字列を保持します。
CREATE TABLE categories_path (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    path VARCHAR(255) NOT NULL, -- 標準フォーマット: 1/2/4/
    INDEX idx_path (path)
);

INSERT INTO categories_path (id, name, path) VALUES
(1, '家電・電子機器', '1/'),
(2, 'スマートフォン', '1/2/'),
(3, 'ノートPC', '1/3/'),
(4, 'iOS', '1/2/4/'),
(5, 'Android', '1/2/5/');
3. Nested Sets(入れ子集合)
木構造を行きがけ順(先行順・pre-order traversal)で走査して番号を割り振るモデルです。各ノードはlft(left)とrgt(right)という2つの整数値を保持します。すべての子孫ノードは、必ず親ノードの(lft, rgt)の数値範囲内に収まる特性を持ちます。
CREATE TABLE categories_nested (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    lft INT NOT NULL,
    rgt INT NOT NULL,
    INDEX idx_lft_rgt (lft, rgt)
);

INSERT INTO categories_nested (id, name, lft, rgt) VALUES
(1, '家電・電子機器', 1, 10),
(2, 'スマートフォン', 2, 7),
(3, 'ノートPC', 8, 9),
(4, 'iOS', 3, 4),
(5, 'Android', 5, 6);
4. Closure Table(閉包テーブル)
エンティティデータと階層関係を完全に分離し、別々のテーブルで管理します。関連テーブルであるcategory_relationsには、先祖と子孫(ancestor – descendant)のすべての組み合わせペアと、その階層の深さ(depth)を格納します。
CREATE TABLE categories_closure (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL
);

CREATE TABLE category_relations (
    ancestor_id INT NOT NULL,
    descendant_id INT NOT NULL,
    depth INT NOT NULL,
    PRIMARY KEY (ancestor_id, descendant_id),
    INDEX idx_descendant (descendant_id),
    CONSTRAINT fk_ancestor FOREIGN KEY (ancestor_id) REFERENCES categories_closure(id) ON DELETE CASCADE,
    CONSTRAINT fk_descendant FOREIGN KEY (descendant_id) REFERENCES categories_closure(id) ON DELETE CASCADE
);

INSERT INTO categories_closure (id, name) VALUES
(1, '家電・電子機器'), (2, 'スマートフォン'), (3, 'ノートPC'), (4, 'iOS'), (5, 'Android');

-- 自己参照(depth = 0)を含む関係レコードを登録
INSERT INTO category_relations (ancestor_id, descendant_id, depth) VALUES
(1,1,0), (2,2,0), (3,3,0), (4,4,0), (5,5,0),
(1,2,1), (1,3,1), (1,4,2), (1,5,2),
(2,4,1), (2,5,1);
クエリの実行とデータ操作
実際のパフォーマンスの差は、「配下のサブツリー全体の取得」と「ノードの挿入・移動」という2つの代表的なシナリオで最も顕著に現れます。
クエリ1:「スマートフォン」(id = 2)配下のサブツリー全体を取得
- Adjacency List: MySQL 8.0以降やPostgreSQLでは、再帰共通テーブル式(Recursive CTE)を利用できます。アプリケーション層でループ処理を繰り返すことなく、1回のスキャンでクエリを実行可能です。
WITH RECURSIVE SubTree AS ( SELECT id, name, parent_id, 1 AS level FROM categories_adj WHERE id = 2 UNION ALL SELECT c.id, c.name, c.parent_id, st.level + 1 FROM categories_adj c INNER JOIN SubTree st ON c.parent_id = st.id ) SELECT * FROM SubTree; - Path Enumeration: 前方一致の
LIKE演算子を使用することで、B-Treeインデックスを効率的に活用できます。SELECT * FROM categories_path WHERE path LIKE '1/2/%'; - Nested Sets: 4つのモデルの中で最速の読み込み速度を誇ります。複合インデックス
(lft, rgt)を利用したシンプルな数値範囲検索で完結します。SELECT child.* FROM categories_nested parent JOIN categories_nested child ON child.lft BETWEEN parent.lft AND parent.rgt WHERE parent.id = 2; - Closure Table: 再帰演算を必要とせず、2つのテーブルをシンプルに
JOINするだけで取得できます。SELECT c.* FROM categories_closure c JOIN category_relations r ON c.id = r.descendant_id WHERE r.ancestor_id = 2;
クエリ2:新規ノードの追加およびサブツリーの移動
ここでは書き込みコストの差が鮮明に浮き彫りとなります。
- Adjacency List: 子ノードの追加は独立した1行の
INSERTだけで完了します(実行時間は約1ms程度)。ツリーの枝を移動する場合も、parent_idを1行UPDATEするだけです。非常に高速かつ安全です。 - Path Enumeration: 新規ノードの追加時は、親ノードのpath文字列を取得して新しいIDを連結するだけで済みます。しかし、親ノードを別の場所に移動する際は、配下にあるサブツリー全体の
path文字列を文字列関数で一括置換・更新する必要があります。 - Nested Sets: データの書き込みコストが極めて高くなります。ツリーの途中に新規ノードを挿入すると、それ以降にあるすべてのノードの
lftおよびrgtの値を再計算して更新(+2)しなければなりません。-- ロックを伴うトランザクション内での実行が必須 UPDATE categories_nested SET rgt = rgt + 2 WHERE rgt > 4; UPDATE categories_nested SET lft = lft + 2 WHERE lft > 4; INSERT INTO categories_nested (name, lft, rgt) VALUES ('HarmonyOS', 5, 6);50万件規模のテーブルでは、この2行の
UPDATEが数十万行をスキャンすることになり、広範囲なテーブルロックやI/Oボトルネックを容易に引き起こします。 - Closure Table: 新規ノードを追加する際は、カテゴリテーブルに1行挿入し、親ノードが持つすべての関係性を新しいノードへ複製して登録します。
INSERT INTO categories_closure (id, name) VALUES (6, 'HarmonyOS');
INSERT INTO category_relations (ancestor_id, descendant_id, depth)
SELECT ancestor_id, 6, depth + 1
FROM category_relations
WHERE descendant_id = 2
UNION ALL
SELECT 6, 6, 0;
この処理は関連テーブルに新規レコードを追加するだけであり、既存のデータを変更・更新することはありません。
総合比較表
| 比較項目 | Adjacency List | Path Enumeration | Nested Sets | Closure Table |
|---|---|---|---|---|
| サブツリー取得 | 良好(再帰CTE) | 高速(インデックスLIKE) | 最速(BETWEEN) | 非常に高速(JOIN) |
| 先祖ノードの取得 | 良好(再帰CTE) | 文字列分割 / CTEが必要 | 非常に高速 | 非常に高速(depth > 0) |
| ノードの新規追加 | 最速(INSERT 1回) | 高速(INSERT 1回) | 極めて低速(lft/rgt再計算) | 高速(数レコードのINSERT) |
| サブツリーの移動 | 極めて容易(1行UPDATE) | 複雑(文字列の一括更新) | 極めて複雑・デッドロック頻発 | 簡潔(関係の削除と再登録) |
| 参照整合性制約 | 強固(外部キー) | 脆弱(文字列依存) | 脆弱(数値ロジック依存) | 強固(外部キー) |
| ストレージ容量 | O(N) – 最小限 | O(N) – 少ない | O(N) – 少ない | O(N * depth) – ディスク消費大 |
パフォーマンスの検証と監視
本番環境でシステムを安定稼働させるには、EXPLAIN ANALYZEを活用してインデックスの適用状況と実行計画を検証することが不可欠です。
1. Path Enumerationにおけるインデックスの落とし穴
LIKEを使用する際の典型的なアンチパターンは、ワイルドカードを先頭に配置することです(LIKE '%/2/%')。この指定を行うとB-Treeインデックスが無効化され、フルテーブルスキャン(Full Table Scan)が強制されます。50万行規模のテーブルでは、実行時間が3msから800ms以上へと急増する恐れがあります。
Index Range Scanを確実に効かせるためには、常に前方一致を維持する必要があります。
-- 推奨: インデックスレンジスキャンを活用(実行時間: 約2〜3ms)
EXPLAIN ANALYZE SELECT * FROM categories_path WHERE path LIKE '1/2/%';

-- 非推奨: 前方一致が崩れフルテーブルスキャンが発生(実行時間: 約800ms)
EXPLAIN ANALYZE SELECT * FROM categories_path WHERE path LIKE '%/2/%';
2. Adjacency Listにおける再帰無限ループのリスク
再帰CTEはメモリ上にテンポラリテーブルを生成します。MySQLのシステム変数cte_max_recursion_depthは、デフォルトで1,000回のループ上限が設定されています。プログラムのバグによってデータに循環参照が発生した場合(ノードAが親としてノードBを指し、ノードBが再びAを指すなど)、クエリはリソースを食いつぶし、タイムアウトに達するまでハングアップします。
-- 現在の再帰深度の上限を確認
SHOW VARIABLES LIKE 'cte_max_recursion_depth';

-- 実際の木構造がより深い場合はセッション単位で制限を緩和
SET SESSION cte_max_recursion_depth = 5000;
3. 実務におけるモデル選定の指針
- Adjacency List + 再帰CTE: MySQL 8.0以上またはPostgreSQLで稼働する、現代のWebアプリケーションの80%に最適な選択肢です。テーブル構造が極めてシンプルで、外部キーによるデータ整合性が保証され、深さ10〜15階層未満のツリーであれば非常に快適に動作します。
- Closure Table: Redditスタイルの多階層コメントシステムや、複雑に分岐する権限管理ツリーを構築する際に強力な投資となります。任意の2ノード間の距離の算出や、テーブルロックを起こさずに高速でブランチを移動させたい要件に向いています。
- Nested Sets: データの読み書き比率が99対1を超えるような、準静的なデータにのみ推奨されます。代表例は行政区画データ(国 > 都道府県 > 市区町村 > 町名)です。行政界のデータが更新されることは極めて稀である一方、特定エリア配下の全データを一括取得するクエリは頻繁に実行されます。
- Path Enumeration: 追加のJOINや再帰処理の負荷をかけずに、UIへパンくずリスト(breadcrumb)を即座に出力したい要件に適した選択肢です。