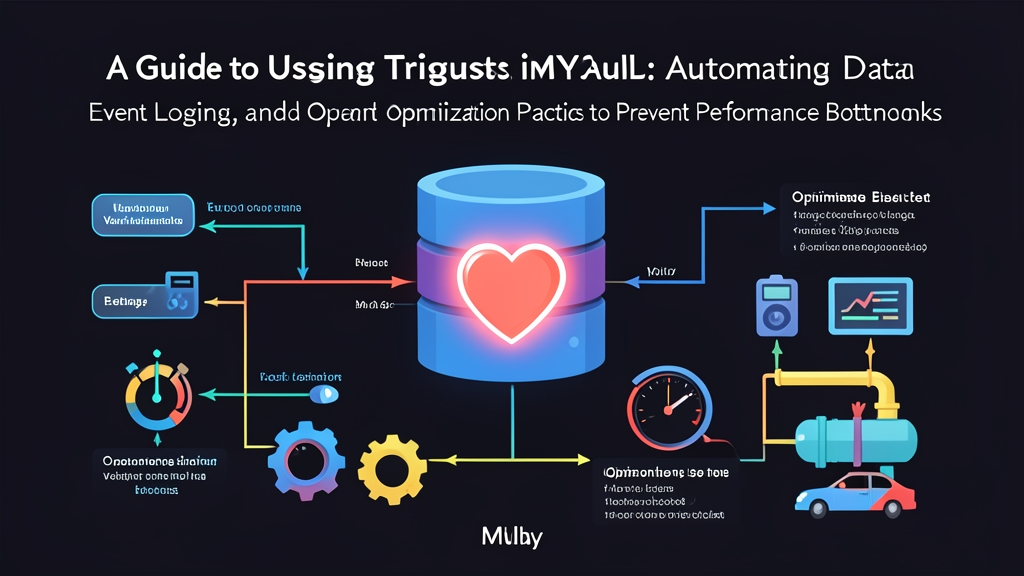
6か月前、私のチームは残高チェックや口座変動の追跡ロジックをすべてMySQL側に移行することを決定しました。これによりデータの整合性は厳格に保てるようになったものの、その後のフラッシュセールで接続プールが上限の500コネクションに達し、システムが停止寸前に追い込まれる事態に直面しました。今回は、本番環境をダウンさせずにトリガー(Trigger)を安全かつ効果的に活用するための実践ノウハウを共有します。
データ処理自動化における3つのアプローチ
例えば「負の数値の入力を禁止する」「タイムスタンプを自動生成する」「テーブルの変更履歴を追跡する」といった要件がある場合、バックエンドエンジニアは主に以下の3つの手法を検討します。
- アプリケーション層(バックエンドコード)での処理: すべてのバリデーションやログ記録ロジックをソースコード側(NestJS、Laravel、Go、Spring Bootなど)に実装します。
- MySQLトリガーの利用: MySQLエンジン内にロジックを直接組み込みます。
INSERT、UPDATE、DELETEの各文が実行された際、MySQLが対応するSQLスクリプトを自動的にトリガーします。 - ストアドプロシージャまたはスケジューリングイベントの利用: すべての書き込み操作をプロシージャ経由に強制するか、定期的にテーブルをスキャンして突合を行うCronジョブを構築します。
本番運用6か月でわかった各アプローチの比較
どの手法にも一長一短があります。解決したい課題に合わせて最適な手段を選択する必要があります。
1. アプリケーション層での処理
- メリット: Podやサーバーを追加することで水平スケール(スケールアウト)が容易です。コードはバージョン管理しやすく、ユニットテストの作成やモックデータの作成もシンプルです。
- デメリット: 複数のマイクロサービスが同一DBに書き込む構成では、バリデーション漏れが発生しやすくなります。また、DBAやエンジニアがDBeaver等を使って手動クエリを実行した場合、ビジネスルールがバイパスされてしまいます。ログ記録のために追加のクエリを発行すると、ネットワークラウンドトリップのオーバーヘッド(クエリあたり約2〜5ms)も発生します。
2. MySQLトリガーの利用
- メリット: API、バックグラウンドワーカー、手動操作のいずれによる書き込みであっても、トリガーなら確実に割り込んで介入できます。InnoDBエンジンのメモリ内で直接実行されるため、ネットワークレイテンシがなく極めて高速です。
- デメリット: 自動テストを書くのが困難です。ロジックがDB層に隠蔽されるため、新規参画メンバーがバックエンドコードを読む際に見落としがちになります。最も危険なのは、トリガーが親ステートメントと同一トランザクション内で実行される点です。トリガーの処理が遅延するとロック保持時間が長期化し、システム全体のスループットが著しく低下します。
3. ストアドプロシージャとスケジューリングイベント
- メリット: 書き込みロジックを標準化されたフローに集約でき、バックグラウンドジョブとして実行すればユーザーのメインリクエストをブロックしません。
- デメリット: スケジューリングイベントには必ずタイムラグ(数秒から数分の遅延)が生じます。また、ストアドプロシージャはPrisma、TypeORM、Hibernateといった主要なORMとの相性が悪く、実装が煩雑になりがちです。
トリガーを採用すべきタイミングとは?
トリガーは万能の銀の弾丸ではありません。主に以下の2つのユースケースにおいて真価を発揮します。
- 改ざんを許さない監査ログ(Audit Log)の記録: ウォレット残高、注文ステータス、管理者権限の変更など、機密性の高いテーブルの追跡。絶対に改ざんが許されない透明性の高いデータ保持が求められる場合です。
- 複雑な制約のバリデーション: 標準の
CHECK制約やFOREIGN KEY制約だけではカバーできない、テーブルを跨ぐような複合条件を検証する場合です。
秒間5,000回以上の書き込み(Write Request)が発生するような高負荷システムでは、ログ記録をメッセージキュー(Kafka、RabbitMQなど)に移管し、非同期で処理する構成を推奨します。一方、中小規模のシステム(秒間500回未満の書き込み)であれば、トリガーは手軽で信頼性の高い選択肢となります。
代表的な2つのトリガー実装パターン
1. 基本構文とコンテキスト変数
MySQLのトリガーは、タイミング(BEFORE / AFTER)、イベント(INSERT / UPDATE / DELETE)、そしてコンテキストの3要素で構成されます。コンテキストでは、更新・削除前の既存レコードを表すOLDと、挿入・更新されようとしている新規レコードを表すNEWが使用可能です。
2. パターン1: BEFORE INSERTによるデータのバリデーションと正規化
要件: ユーザーテーブルにおいて、メールアドレスを常に小文字(lowercase)に正規化し、初期残高が0未満にならないよう検証します。
DELIMITER $$

CREATE TRIGGER trg_users_before_insert
BEFORE INSERT ON users
FOR EACH ROW
BEGIN
    -- メールアドレスの自動正規化
    SET NEW.email = LOWER(TRIM(NEW.email));

    -- ビジネスルールに反する不正データの遮断
    IF NEW.balance < 0 THEN
        SIGNAL SQLSTATE '45000'
        SET MESSAGE_TEXT = 'ビジネスロジックエラー: 口座残高を0未満にすることはできません。';
    END IF;
END$$

DELIMITER ;負の残高を挿入しようとした場合、MySQLは即座にトランザクションをロールバックし、SQLSTATE 45000エラーを返します。不正なデータがDBに侵入するのを確実に防ぎます。
3. パターン2: AFTER UPDATEによる監査ログの自動記録
注文ステータスが「いつ」「どのように」変更されたかを確実に記録する、実務で非常によくあるユースケースです。
-- 変更履歴を保存する監査ログテーブル
CREATE TABLE order_audit_logs (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    order_id BIGINT NOT NULL,
    old_status VARCHAR(50),
    new_status VARCHAR(50),
    changed_at DATETIME DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_order_id (order_id)
) ENGINE=InnoDB;

-- ステータス変更を監視するトリガー
DELIMITER $$

CREATE TRIGGER trg_orders_after_update
AFTER UPDATE ON orders
FOR EACH ROW
BEGIN
    -- ステータスが実際に変更された場合のみ記録
    IF OLD.status <> NEW.status THEN
        INSERT INTO order_audit_logs (order_id, old_status, new_status, changed_at)
        VALUES (OLD.id, OLD.status, NEW.status, NOW());
    END IF;
END$$

DELIMITER ;
本番環境でトリガーを安全に運用するための4つの鉄則
私の運用環境はMySQL 8.0、DBサイズ60GB超、秒間約300トランザクションを処理しています。ピーク時にも安定稼働を維持するために実践しているルールがこちらです。
1. トリガーの処理は極限まで軽量に保つ
トリガー内部で複雑なサブクエリや多数のテーブルJOINを実行することは絶対に避けてください。トリガーの処理が1ms長引くだけで、行ロック(Row Lock)の保持時間がそのまま延長されます。後続のトランザクションが待機列に溜まり、最悪の場合はLock wait timeout exceededエラーが頻発します。
2. テーブル跨ぎの更新によるデッドロックの回避
例えば、ordersテーブルのトリガーがwalletsテーブルを更新し、同時に別APIがwalletsを更新した後にordersを更新するような処理があると、相互にロックを取り合ってデッドロックが発生します。安全性を重視するなら、トリガー内では現在の行への値代入(NEWの使用)か、監査ログテーブルへのINSERTのみに留めるのがベストプラクティスです。
3. 監査ログテーブルの不要なインデックスを削減する
ログテーブルは増加ペースが早く、週に数百万件規模で肥大化することがあります。このテーブルにインデックスが多すぎると、トリガー経由のINSERT処理が重くなり、元の親クエリ全体の遅延を引き起こします。Primary Keyと、検索に必須となるカラム(order_idなど)のインデックスだけに絞り込みましょう。
4. マイグレーションファイルによるトリガーのコード管理
GUIツールを使って本番環境で直接トリガーを作成・修正してはいけません。トリガーの定義は必ずプロジェクトのマイグレーションファイルに含め、Gitでバージョン管理を行ってください。サーバー上で状態を確認したり更新したりする際は、以下のコマンドを使用します。
-- ordersテーブル上のトリガー一覧を確認
SHOW TRIGGERS LIKE 'orders';

-- 新バージョン適用前に既存のトリガーを削除
DROP TRIGGER IF EXISTS trg_orders_after_update;
トリガーはデータの整合性を守る「最後の防波堤」です。適切なユースケースを見極め、ロジックを極力シンプルに保ち、行ロックのオーバーヘッドを常に意識した上で本番環境に導入しましょう。