MySQLにおけるデータ検索アプローチの比較
1,000万件以上のレコードを保持するusersテーブルを運用していると仮定しましょう。上司から「ダナン出身のマーケティング部門の従業員一覧を取得してほしい」と依頼されました。このとき、MySQLはどのようにデータを検索するのでしょうか。代表的な4つのアプローチを比較します。
- Approach 1: Full Table Scan(フルテーブルスキャン)
テーブルの先頭から末尾まで全行を走査します。ディスクI/Oの負荷が極めて高く、データ量が数百万行に達すると、クエリの応答に3〜8秒ほどかかることがよくあります。 - Approach 2: Single Index Scan(単一インデックススキャン)
department_idのインデックスを使用して、マーケティング部門の20万件を抽出します。その後、出身地を確認するためにクラスタ化インデックス(clustered index)から1行ずつレコードを読み取ります。フルテーブルスキャンより高速ですが、ランダムI/Oの回数は依然として膨大です。 - Approach 3: Index Merge(複数インデックスのマージ)
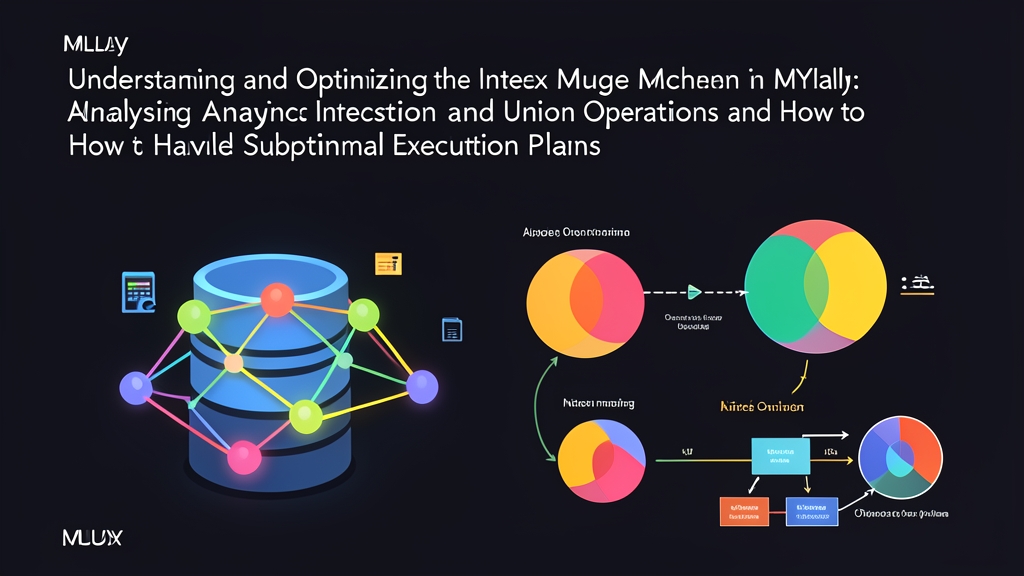
idx_deptとidx_cityという2つの個別インデックスを並行して読み取ります。すぐに実データを読み出すのではなく、MySQLはメモリ上で2つのPrimary Key(Row ID)リストの積集合(intersection)や和集合(union)を算出します。絞り込まれた主キーリストが確定してから、実際の実データを取得します。 - Approach 4: Composite Index(複合インデックス)
(department_id, city)の組み合わせでインデックスをあらかじめ作成しておきます。データはすでに論理順にソートされているため、MySQLは該当箇所へピンポイントでシークし、IDのマージ処理なしにわずか数ミリ秒で連続して読み取ることができます。
Index Mergeメカニズムのメリット・デメリット分析
「カラムごとに個別のインデックスを作成しておけば、クエリは自動的に速くなる」と誤解されがちです。しかし実際には、MySQLのコストベース最適化(CBO: Cost-based Optimizer)はインデックスをマージする前にコスト計算を行っており、その結果選ばれた実行計画が深刻なボトルネックになるケースも少なくありません。
Index Mergeには主に3つのメカニズムが存在します。
1. Using intersect(インデックスの積集合)
単一インデックスが設定された複数のカラムがAND演算子で結合されたクエリで発生します。
SELECT id, username, email FROM users
WHERE department_id = 4 AND status = 'active';
メリット: 既存のインデックスを活用できるため、ディスクへの書き込み性能を低下させる新規インデックスの追加を回避できます。
デメリット: 両方のインデックスから得られた主キーの集合全体をRAMにロードして突合する必要があります。各条件に30万件がヒットする場合、intersectのアルゴリズムは大量のCPUリソースを消費します。処理時間が1.5秒に達することもあり、単一インデックスのスキャンよりも遅くなる場合があります。
2. Using union(インデックスの和集合)
このシナリオは、OR演算子を含むクエリで発生します。
SELECT id, username, email FROM users
WHERE email = '[email protected]' OR phone_number = '0901234567';
メリット: OR条件において単一インデックスしか使えない場合、もう一方の条件判定でフルテーブルスキャンが発生してしまいます。Index Merge Unionを利用すれば、双方のインデックスを走査した上で結果を統合できます。
デメリット: レコードを返す前に重複する主キーを排除(deduplication)するため、バッファメモリを消費します。
3. Using sort_union(ソート後の和集合)
Unionと類似していますが、OR条件に範囲比較(>、<、BETWEENなど)が含まれる場合にトリガーされます。
SELECT id, name FROM products
WHERE price < 50000 OR category_id = 12;
メリット: OR句に複雑な条件が含まれる場合でも、フルテーブルスキャンを回避できます。
デメリット: RAMリソースを大量に消費します。レンジスキャンから取得されたRow IDの集合は順序が揃っていないため、MySQLはマージ前にsort_buffer_sizeを使用してすべての主キーをソートし直す必要があります。
Optimizerの実行計画が適切でない場合の判断基準
MySQLのオプティマイザは、統計情報(カーディナリティや推定データページ数)に基づいてコストを算出します。しかし、データの偏り(データスキュー)がある場合、統計情報に乖離が生じることがあります。その結果、より最適なインデックスがあるにもかかわらず、OptimizerがIndex Mergeを選択してしまうことがあります。
実務で判断するための実践的なガイドラインは以下の通りです。
- Index Mergeを維持するケース: 選択度が高い(高カーディナリティな)カラムに対する
OR検索に適用します。また、インデックスの追加によってINSERT/UPDATEのスループット低下を避けたい、書き込み頻度が高いテーブル(毎秒1,000回以上の書き込みなど)にも適しています。 - 複合インデックス(Composite Index)へ置き換えるケース: 実行頻度の高い
ANDクエリに適用します。複合インデックス(col1, col2)を導入することで、メモリ上でのIDフィルタリング工程が完全に排除され、クエリ実行時間を1,200msから8ms未満へと劇的に短縮できます。 - Index Mergeを無効化、またはHint句で制御するケース: Optimizerが2つの大規模なデータセットをマージしようとしてCPU使用率が100%に達してしまうような緊急時に適用します。
実践的な調査と改善のステップ
ステップ1: EXPLAINによるIndex Mergeの検知
レイテンシが異常に高くなっているクエリに対して、実行計画の分析コマンドを実行します。
EXPLAIN SELECT id, username FROM users
WHERE role = 'manager' AND created_at >= '2026-01-01';
typeカラムがindex_mergeを示し、ExtraカラムにUsing intersect(idx_role, idx_created_at)と出力されている場合、MySQLはこれら2つの単一インデックスをマージして処理しています。
ステップ2: 最適な複合インデックスへの置き換え
AND条件を使用するクエリの場合、適切なカラム順序で複合インデックスを設計することで問題を根本的に解消できます。
-- 選択度が高いカラム、または等価条件(=)のカラムを前方に配置する
CREATE INDEX idx_role_created_at ON users (role, created_at);
再度EXPLAINで確認すると、typeカラムはrangeまたはrefに変わり、keyには直接idx_role_created_atが適用されます。メモリ上での中間処理ステップは完全に不要になります。
ステップ3: Optimizer SwitchまたはIndex Hintによる制御
本番環境のテーブルサイズが極めて大きく、すぐにDDLマイグレーションを実行できない場合は、セッションレベルでIndex Mergeを無効化します。
-- 現在のセッションでIndex Merge機能を完全に無効化する
SET SESSION optimizer_switch = 'index_merge=off';

-- またはIntersectメカニズムのみを個別に無効化する
SET SESSION optimizer_switch = 'index_merge_intersection=off';
他の接続に影響を与えず個々のクエリ単位で対応したい場合は、従来のIndex Hintを使用します。
-- MySQLにidx_created_atインデックスのみを使用するよう強制する
SELECT id, username FROM users USE INDEX (idx_created_at)
WHERE role = 'manager' AND created_at >= '2026-01-01';
あるいは、MySQL 8.0以降で推奨される標準のOptimizer Hint構文を使用します。
SELECT /*+ NO_INDEX_MERGE(users idx_role, idx_created_at) */ id, username
FROM users
WHERE role = 'manager' AND created_at >= '2026-01-01';
Index Mergeの本質的な挙動を正しく理解することで、実行計画をプロアクティブにコントロールし、p99レイテンシを低く維持しながらトラフィック急増時にも耐えうるデータベースを構築できます。