深夜2時の悪夢:データベースのダウンと鳴り止まないPagerDuty
深夜2時、静まり返った部屋にPagerDutyのアラート音がけたたましく鳴り響きます。注文トランザクションを処理していたプライマリデータベース(Primary)が、ハードウェア障害によって突然ダウン。Grafanaのダッシュボード上では500エラー率が垂直に跳ね上がっています。眠い目をこすりながら飛び起き、ノートPCを開いてレプリカへSSHログイン。重圧がのしかかる中、binlogのポジションを確認し、セカンダリノードをプライマリへ昇格させるコマンドを打ち込み、各マイクロサービスの接続先DBのIPアドレスを慌てて書き換えて回る……。
この一連の手動オペレーションだけで、貴重なダウンタイムが45分も浪費されてしまいました。その結果、1,200件以上のカートが放棄され、カスタマーサポートには問い合わせが殺到、チーム全体が翌朝の役員への障害報告対応に追われることになったのです。問題の本質はオンコール担当者のスキル不足ではありません。真の過ちは、システムの命運を「真夜中の手動コマンド操作」に委ねていたアーキテクチャそのものにあります。
従来のレプリケーション構成では不十分な理由
クラシックなSource – Replica(Master – Slave)構成は、小規模なシステムであれば十分に機能していました。しかし、高負荷な本番環境においては、以下の3つの致命的な弱点が露呈します。
- 非同期(Asynchronous)レプリケーションの限界:プライマリノードはローカルストレージへの書き込みが完了した時点で、即座にクライアントへ成功レスポンスを返します。レプリカがイベントを受信できたかどうかは関知しません。そのため、ネットワーク経由でbinlogを転送し切る前にプライマリがクラッシュした場合、直近のトランザクションデータは永久に失われてしまいます。
- 自動復旧メカニズムの欠如(No Auto-failover):従来の単体MySQLサーバーには、ノードのダウンを自動検知して新たなノードを選出する機能が備わっていません。フェイルオーバーの判断はすべて人間による介入か、外部スクリプトに依存せざるを得ません。
- スプリットブレインの恐怖:自作のフェイルオーバースクリプトを使用している場合、わずか5〜10秒のネットワーク瞬断でプライマリとの接続が切れただけでも、スクリプトが誤判定してレプリカを第2のプライマリへと昇格させてしまう危険性があります。ネットワークが復旧した時には2つのノードが同じauto-increment ID空間で同時に書き込みを受け付けてしまい、データの競合・不整合が発生して復旧が極めて困難になります。
MySQLにおける高可用性(HA)ソリューションの比較
単一障害点(SPOF)を排除するにあたり、インフラエンジニアは一般的に以下の3つの選択肢を検討します。
- Master-Slave + Orchestrator + Keepalived構成:GitHub Orchestratorによるトポロジー管理は非常に優秀です。しかし、Orchestrator用のRaftクラスタを別途立ち上げ、Virtual IP(VIP)を構成し、周辺の補助サービスを複数運用保守しなければならないという運用の複雑さが伴います。
- Percona XtraDB Cluster / Galera Cluster:マルチマスター構成(Multi-master)と書き込み認証メカニズムを採用したソリューションです。データの複製は極めて強固である一方、GaleraはInnoDBのトランザクション層に深く介入します。同一データセットに対する並行書き込み負荷が高まると、認証失敗(certification failure)によるロールバック率が急増する傾向があります。
- MySQL InnoDB Cluster(Group Replication + MySQL Shell):Oracleが公式に開発・提供する完全統合型のHAソリューションです。MySQL 5.7から導入され、MySQL 8.0で大幅に最適化されました。Paxosコンセンサスアルゴリズム(XComエンジン経由)を採用し、ノードの過半数合意によってトランザクションをコミットします。最大の強みは、サードパーティ製ツールを別途導入することなく、わずか2〜3秒で新しいPrimaryを自動選出できる点です。
MySQL InnoDB Clusterの標準アーキテクチャ
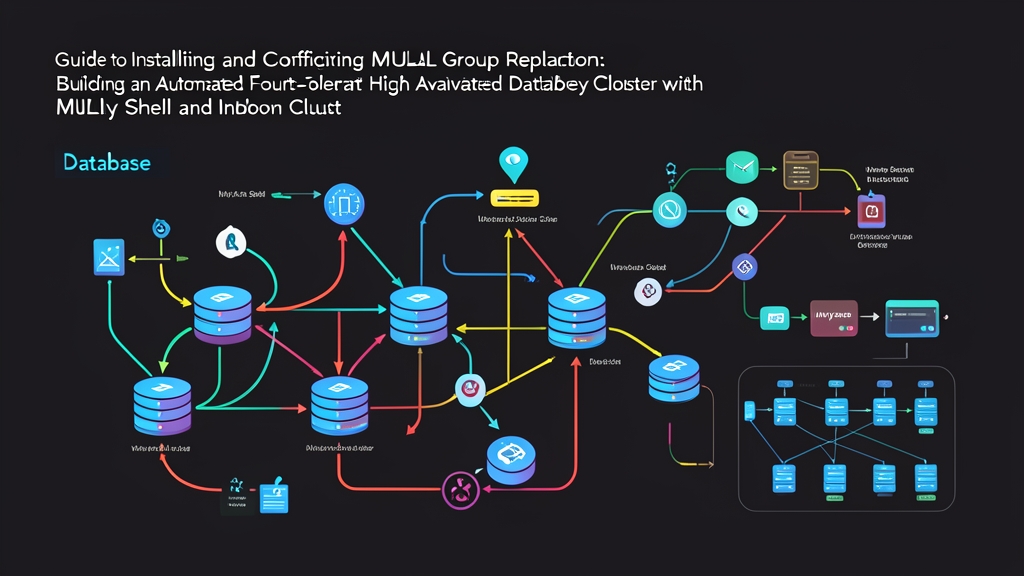
無数の設定ファイルをつなぎ合わせる必要はありません。InnoDB Clusterは高可用性アーキテクチャ全体を、緊密に連携する3つのコンポーネントへと集約しています。
- Group Replication:クラスタの心臓部。過半数の合意原則(Quorum)に基づき、分散データの安全な整合性を保証します。
- MySQL Shell(AdminAPI):PythonおよびJavaScriptに対応した新世代の高度なCLIツールです。数行の短い関数を呼び出すだけで、ノードのプロビジョニング、構成、クラスタへの参加が完了します。
- MySQL Router:アプリケーションサーバー上に同居させる超軽量プロキシ層です。クラスタのトポロジー変化を自動検知し、書き込みクエリをポート6446(Primary)、読み取りクエリをポート6447(Replica)へと自動ルーティングします。
ステップ1:インフラ環境の準備
Quorum(過半数合意)を維持し、1ノードの障害時にもクラスタを継続稼働させるためには、最低3台の物理サーバーまたは独立したVPSが必要です。単一の仮想化ホスト上に同居させる構成は避けてください。
- Node 1:
192.168.1.11(mysql-node1) - Node 2:
192.168.1.12(mysql-node2) - Node 3:
192.168.1.13(mysql-node3)
ステップ2:3台のノードでmy.cnf設定ファイルを標準化
各サーバーの /etc/mysql/mysql.conf.d/mysqld.cnf を開きます。GTIDの有効化とwrite setトラッキングに必要なパラメータを追記します。
[mysqld]
server_id = 1 # 各サーバーに応じて 2 および 3 に変更
gtid_mode = ON
enforce_gtid_consistency = ON
binlog_format = ROW
binlog_checksum = NONE

# Group Replication 必須設定
transaction_write_set_extraction = XXHASH64
loose-group_replication_bootstrap_group = OFF
loose-group_replication_start_on_boot = OFF

# リッスンIPおよびホストの指定
bind-address = 0.0.0.0
report_host = 192.168.1.11 # 各ノードの実際のIPアドレスを指定
ファイルを保存し、3台すべてのサーバーでMySQLプロセスを再起動します。
sudo systemctl restart mysql
ステップ3:MySQL Shellによるノード構成の自動最適化
MySQL Shellの最大の特長は、構成エラーを自動検出・修正できる点です。Node 1にMySQL Shellをインストールします。
sudo apt update && sudo apt install -y mysql-shell
MySQL Shellを起動し、ローカルインスタンスに接続します。
mysqlsh [email protected]:3306
\js コマンドでJavaScriptモードに切り替えます。続けて、設定の自動検証・修正関数を実行します。
// Node 1の前提条件をチェック
dba.checkInstanceConfiguration('[email protected]:3306');

// 不足しているシステム変数を自動修正し、クラスタ管理用ユーザーを作成
dba.configureInstance('[email protected]:3306');
Node 2(192.168.1.12)およびNode 3(192.168.1.13)に対しても同様に dba.configureInstance() を実行します。煩雑な内部変数を1つずつ手動で覚える必要はなく、MySQL Shellがすべて自動で処理してくれます。
ステップ4:Node 1でクラスタを初期化
3台のノードの準備が整ったら、データ競合を防ぐためにSingle-Primaryモード(書き込み1台、読み取り2台)でクラスタを作成します。
// Node 1へのセッションを接続
shell.connect('[email protected]:3306');

// prodClusterという名前でクラスタを作成
var cluster = dba.createCluster('prodCluster');
ステップ5:Node 2とNode 3をクラスタに参加させる
開いているMySQL Shellのプロンプトから、残り2台のメンバーを順次追加します。
// Node 2を追加
cluster.addInstance('[email protected]:3306', { recoveryMethod: 'auto' });

// Node 3を追加
cluster.addInstance('[email protected]:3306', { recoveryMethod: 'auto' });
recoveryMethod: 'auto' オプションはMySQL 8の強力な機能です。MySQL Clone Pluginをトリガーし、Primaryから新規ノードへバイナリデータをダイレクトにストリーミングします。50GB程度のデータベースであれば、手動でのSQLダンプ・リストアを行うことなく、わずか3分足らずで同期を完了できます。
ステップ6:クラスタの健全性ステータスを確認
3台のノードが正常に相互認識されているかを確認するため、以下のコマンドを実行します。
cluster.status();
画面に詳細なJSONレスポンスが出力されます。特に以下の2つのキー項目に注目してください。
"status": "OK",
"topology": {
    "192.168.1.11:3306": { "mode": "R/W", "role": "HA", "status": "ONLINE" },
    "192.168.1.12:3306": { "mode": "R/O", "role": "HA", "status": "ONLINE" },
    "192.168.1.13:3306": { "mode": "R/O", "role": "HA", "status": "ONLINE" }
}
全ノードが ONLINE と表示されていれば、本番トラフィックを受け入れる準備が完了しています。
ステップ7:障害シミュレーションによるフェイルオーバー検証
自身のチームで実際に停止テストを行っていないHAクラスタを、本番環境に投入してはなりません。Primary(Node 1)のMySQLプロセスを強制停止してみましょう。
# Node 1のターミナル上で直接実行
sudo systemctl stop mysql
直ちにNode 2のMySQL Shellへ接続し、クラスタの挙動を監視します。
mysqlsh [email protected]:3306
var cluster = dba.getCluster('prodCluster');
cluster.status();
わずか2〜3秒の間に、残された2台のノードがNode 1のハートビート途絶を検知します。Quorum投票が行われ、Node 2が新たな R/W(PRIMARY)へと自動昇格します。Node 1は自動的に (MISSING) ステータスへ移行します。一連のフェイルオーバーは無瞬断に近いレベルでスムーズに完了し、アプリケーション側でロック待機によるスタックも発生しません。
本番環境運用のための実践プラクティス
- すべてのテーブルにPrimary Keyを必須化する:Group Replicationは主キーに基づく書き込み認証メカニズムを採用しています。Primary Keyが存在しないテーブルに対しては、クラスタ側で
INSERTやUPDATEなどのクエリが拒否されます。 - ネットワークレイテンシを5ms未満に抑える:書き込みごとにノード過半数からの応答確認を必要とするため、ノード間のpingレイテンシが増大するとアプリケーションの応答性能に直結します。ノード間は同一のVPC(仮想プライベートクラウド)またはローカルエリアネットワーク内に配置してください。
- 必ずMySQL Routerを併用する:バックエンドアプリケーションに個別ノードのIPアドレスを直接ハードコードしてはいけません。アプリケーションサーバー上にMySQL Routerをデプロイすることで、新しく昇格したPrimaryを自動追従・ルーティングさせることができます。