従来のVoice AIにおける「レイテンシの悪夢」
注文状況を確認するためにAIコールセンターに電話をかける場面を想像してみてください。あなたが「注文番号12345を確認してください」と言い終わった直後、受話器の向こうで3〜5秒もの沈黙が続きます。あまりの静けさに、通話が切れてしまったのではないかと不安になるほどです。
それだけではありません。ボットが誤った情報を話し始めたため慌てて訂正しようと声をかけても、残念ながらボットは意に介さず、30秒もの台本を最後まで一方的に喋り続けてからでないとこちらの話を聞いてくれません。
このような対話は、途切れ途切れで不自然かつストレスの溜まるやりとりにしかなりません。ユーザーは「スマートなAIアシスタントと会話している」という感覚を全く得られないのです。
原因の解剖:なぜ音声ボットの応答は遅いのか?
3〜5秒もの遅延は、HTTPプロトコルを介した逐次的なバッチ処理(batch processing)によって発生します。
- 発話終了の待機(無音検出 / Silence Detection): ユーザーが話し終えたことを確実に判定するため、システムは0.7〜1.2秒ほどの完全な無音を待つ必要があります。
- 音声のテキスト変換(STT): 録音ファイル全体をSTTサーバーに送信してテキスト化します(さらに400〜800ms消費)。
- LLMの全回答生成の待機: プロンプトがLLMに送信され、モデルが完全な応答文を出力し終えるまで待機します(800〜1500ms消費)。
- テキストの音声変換(TTS): 生成された全文をTTSサービスに送信し、音声ファイルを生成します(600〜1000ms消費)。
- 音声のダウンロードと再生: クライアントがHTTP経由でMP3/WAVファイル全体をダウンロードしてから再生を開始します。
ネットワーク遅延と各ステップの処理時間が積み重なることで、ボットの応答が致命的に遅くなるのは避けられません。
リアルタイムVoice AIへの3つのアプローチ
レイテンシを数秒から800ms未満(人間同士の自然な対話と同等の応答速度)まで短縮するために、エンジニアは通常次の3つのアプローチを検討します。
1. WebSocketで各APIを独自に連携・実装する
Deepgram(STT)、OpenAI(LLMストリーミング)、ElevenLabs(TTSストリーミング)へのWebSocket接続を並行して確立します。ユーザーが発話すると同時に音声をストリーミング送信し、LLMが最初の3〜4トークンを出力した段階ですぐにTTSへ送ってチャンク単位で音声を合成します。
- メリット: コード全体を完全に制御でき、サードパーティ製フレームワークに依存しない。
- デメリット: 実装が極めて複雑。ストリームの同期、エコーキャンセレーション(echo cancellation)、音声バッファ管理、割り込み(barge-in)アルゴリズムなどをすべて自前で処理する必要がある。
2. 商用のパッケージ化されたプラットフォームを利用する(Vapi、Retell AI)
直感的なダッシュボードとともに、Voice Agentのインフラ全体をターンキーで提供するSaaSサービスです。
- メリット: 数時間で迅速に導入可能で、電話回線(Twilio/Vonageなど)との連携も組み込み済み。
- デメリット: 継続コストが高い(LLM/TTSのAPI利用料に加えて通常1分あたり0.05〜0.15ドル)、ベンダーロックイン(vendor lock-in)が発生し、内部ロジックの高度なカスタマイズが難しい。
3. PipecatとWebRTCを組み合わせて利用する
速度、高いカスタマイズ性、運用コストの最適化をバランスよく兼ね備えたオープンソースソリューションです。
Pipecat + WebRTC:Voice Agentのための最強の組み合わせ
Pipecatは、リアルタイムで音声やビジュアルに対話するエージェントを構築するために設計されたPython製のオープンソースフレームワークです。
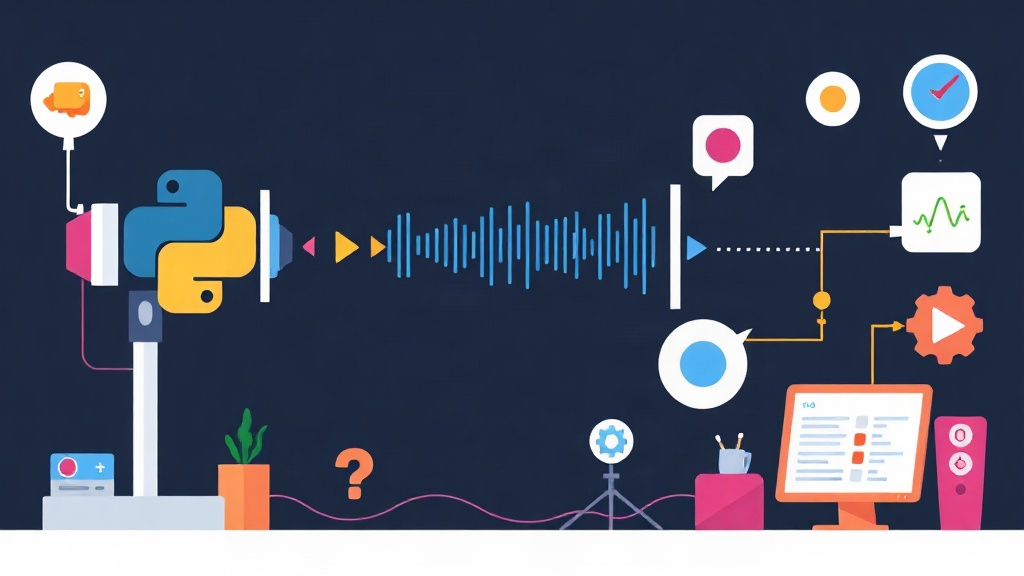
重厚な音声ファイル単位で処理するのではなく、Pipecatはパイプライン(pipeline)アーキテクチャとして動作します。マイクからの音声は極めて短いフレーム(約20〜40ms)に細分化され、以下のパイプラインを連続的に流れていきます。
マイク → Silero VAD → STT (ストリーミング) → LLM (トークン) → TTS (音声チャンク) → スピーカー再生
WebRTC(DailyやLiveKitなどのインフラ経由)と組み合わせることで、双方向の音声伝送遅延はわずか50〜150ms程度に抑えられます。さらに、ユーザーが発話を遮って話し始めた場合(barge-in)、VADアナライザーが即座にキャンセルシグナル(interruption frame)をパイプライン全体に送信します。ボットは瞬時にスピーカー出力を停止し、スレッドをフリーズさせることなく新しい発話の聞き取りへと切り替わります。
Pipecatを使ったVoice Agentの構築手順
ステップ1:環境準備とライブラリのインストール
Python 3.10以上の仮想環境を作成し、Pipecatと必要なプラグインをインストールします。
# 仮想環境の作成と有効化
python3 -m venv venv
source venv/bin/activate

# Pipecatと各種コネクタのインストール
pip install "pipecat-ai[daily,openai,deepgram,silero]" python-dotenv loguru
API設定情報を保持する .env ファイルを作成します:
DEEPGRAM_API_KEY=your_deepgram_api_key
OPENAI_API_KEY=your_openai_api_key
DAILY_API_KEY=your_daily_api_key
DAILY_SAMPLE_ROOM_URL=https://yourdomain.daily.co/your-room-name
ステップ2:音声処理パイプラインの構築
非同期処理(asyncio)を用いた bot.py ファイルを作成します:
import os
import sys
import asyncio
from dotenv import load_dotenv
from loguru import logger

from pipecat.audio.vad.silero import SileroVADAnalyzer
from pipecat.pipeline.pipeline import Pipeline
from pipecat.pipeline.runner import PipelineRunner
from pipecat.pipeline.task import PipelineParams, PipelineTask
from pipecat.processors.aggregators.llm_response import (
    LLMAssistantResponseAggregator,
    LLMUserResponseAggregator,
)
from pipecat.services.deepgram import DeepgramSTTService
from pipecat.services.openai import OpenAILLMService, OpenAITTSService
from pipecat.transports.services.daily import DailyParams, DailyTransport

load_dotenv(override=True)

async def main():
    room_url = os.getenv("DAILY_SAMPLE_ROOM_URL")
    token = os.getenv("DAILY_API_KEY")

    if not room_url:
        logger.error(".envファイルにDAILY_SAMPLE_ROOM_URLを設定してください")
        sys.exit(1)

    # 1. DailyによるWebRTC Transportの初期化
    transport = DailyTransport(
        room_url,
        token,
        "Voice AI Assistant",
        DailyParams(
            audio_out_enabled=True,
            vad_enabled=True,
            vad_analyzer=SileroVADAnalyzer(),
            vad_audio_passthrough=True,
        ),
    )

    # 2. 各処理サービスの初期化
    stt = DeepgramSTTService(api_key=os.getenv("DEEPGRAM_API_KEY"))

    llm = OpenAILLMService(
        api_key=os.getenv("OPENAI_API_KEY"),
        model="gpt-4o-mini"
    )

    tts = OpenAITTSService(
        api_key=os.getenv("OPENAI_API_KEY"),
        voice="alloy"
    )

    # 3. 会話コンテキストの設定
    messages = [
        {
            "role": "system",
            "content": "あなたは親切なAIアシスタントです。1〜2文で簡潔かつ自然に応答してください。",
        },
    ]

    tcontext = OpenAILLMService.create_context(messages)
    tcontext_aggregator = llm.create_context_aggregator(tcontext)

    # 4. パイプラインの構築
    pipeline = Pipeline([
        transport.input(),                  # WebRTCからの音声ストリームを受信
        stt,                                # 音声 -> テキスト (ストリーミング)
        tcontext_aggregator.user(),          # ユーザーのテキストをコンテキストに追加
        llm,                                # LLMによる回答生成 (トークン)
        tts,                                # テキスト -> 音声 (チャンク)
        transport.output(),                 # WebRTC経由で音声を再生
        tcontext_aggregator.assistant(),     # ボットの応答をコンテキストに保存
    ])

    task = PipelineTask(pipeline, PipelineParams(allow_interruptions=True))

    @transport.event_handler("on_first_participant_joined")
    async def on_first_participant_joined(transport, participant):
        transport.capture_participant_transcription(participant["id"])
        # ボットから自発的に挨拶を開始
        await task.queue_frames([OpenAILLMService.create_context_frame(messages)])

    runner = PipelineRunner()
    logger.info("Voice Botが起動し、接続待機中です...")
    await runner.run(task)

if __name__ == "__main__":
    asyncio.run(main())
ステップ3:実行テストと検証
ターミナルからアプリケーションを実行します:
python bot.py
ブラウザでDailyルームのURLにアクセスし、マイクをオンにして直接話しかけてみてください。発話を終えてからわずか500〜700ms程度でボットが応答します。また、ボットが話している最中に声を被せてみてください。即座に音声出力が停止し、新しい質問の聞き取りに切り替わることが確認できます。
本番環境(Production)に向けたレイテンシ最適化の秘訣
Voice Agentを検証環境から実際のプロダクション環境へと移行するにあたり、最適化すべき重要なポイントは以下の通りです。
- サーバーの地理的配置(Server Region): ユーザーの所在地に近いリージョンにPipecatサーバーを配置し、WebRTCのPing値を最小限に抑えます(例:東南アジア向けならシンガポールリージョン
ap-southeast-1を選択して35ms未満に維持。米国リージョンを選択すると往復で約200msの余分な遅延が発生します)。 - 対話に特化したTTSの選定: OpenAI TTS(TTFB 約350ms)の代わりに、Cartesia Sonic(約100〜140ms)やElevenLabs Flash v2.5(約150ms)の利用を検討してください。対話体験が大幅にスムーズになります。
- 最初のトークン生成速度(TTFT)が極めて速いLLMの選択:
gpt-4o-miniやclaude-3-5-haikuなどのモデルはTTFTが250ms未満であり、十分なGPUインフラがないセルフホストの70Bモデルよりもはるかに優れた応答性を発揮します。 - VADの発話終了しきい値の調整: Silero VADでは、
stop_secsを0.25〜0.35s程度に設定します。この値であれば、ユーザーの息継ぎによる誤検出を防ぎつつ、発話終了を俊敏に検知できます。