Cơn ác mộng độ trễ khi tương tác với Voice AI truyền thống
Hãy tưởng tượng bạn gọi điện đến một tổng đài AI để tra cứu đơn hàng. Bạn vừa dứt câu hỏi: “Kiểm tra giúp tôi đơn hàng 12345”. Phía bên kia là một khoảng lặng kéo dài 3 đến 5 giây. Không gian tĩnh lặng đến mức bạn tự hỏi liệu đường truyền có bị ngắt hay không.
Chưa hết. Khi bot bắt đầu trả lời sai thông tin, bạn vội lên tiếng đính chính. Đáng tiếc thay, nó vẫn vô tư thao thao bất tuyệt đọc hết kịch bản dài 30 giây rồi mới chịu nghe tiếp.
Cảm giác giao tiếp lúc này biến thành một màn hỏi-đáp đứt quãng, cứng nhắc và gây ức chế. Người nghe không hề có cảm giác đang đối thoại với một trợ lý thông minh.
Giải phẫu nguyên nhân: Tại sao Voice Bot lại phản hồi chậm?
Độ trễ 3-5 giây sinh ra do quy trình xử lý theo lô (batch processing) tuần tự qua giao thức HTTP:
- Chờ dứt câu (Silence Detection): Hệ thống phải đợi người dùng im lặng hoàn toàn khoảng 0.7 – 1.2 giây để chắc chắn bạn đã nói xong.
- Chuyển giọng nói thành văn bản (STT): Gửi toàn bộ file ghi âm lên server STT để dịch (mất thêm 400 – 800ms).
- Chờ LLM sinh toàn bộ câu trả lời: Prompt được đẩy vào LLM. Hệ thống đợi mô hình hoàn thành đầy đủ câu phản hồi (mất 800 – 1500ms).
- Chuyển văn bản thành giọng nói (TTS): Đoạn văn bản hoàn chỉnh được gửi sang dịch vụ TTS để tạo file audio (mất 600 – 1000ms).
- Tải và phát audio: Client tải toàn bộ file MP3/WAV về qua HTTP rồi mới bắt đầu phát.
Khi cộng dồn độ trễ mạng và thời gian xử lý từng bước, việc bot phản hồi chậm chạp là điều tất yếu.
Ba hướng tiếp cận bài toán Voice AI thời gian thực
Để rút ngắn độ trễ từ vài giây xuống dưới 800ms (mức tương đương phản xạ đàm thoại giữa người với người), các kỹ sư thường cân nhắc ba giải pháp:
1. Tự viết mã nguồn kết nối các API qua WebSocket
Bạn tự mở các kết nối WebSocket song song đến Deepgram (STT), OpenAI (LLM streaming) và ElevenLabs (TTS streaming). Khi người dùng vừa nói, âm thanh được đẩy đi liên tục; LLM vừa nhả 3-4 token đầu tiên, bạn gửi ngay sang TTS để tổng hợp âm thanh dạng chunk.
- Ưu điểm: Kiểm soát toàn bộ mã nguồn, không phụ thuộc framework bên thứ ba.
- Nhược điểm: Cực kỳ phức tạp. Bạn phải tự xử lý đồng bộ luồng, triệt tiêu tiếng vọng (echo cancellation), quản lý audio buffer và thuật toán ngắt lời (barge-in).
2. Sử dụng nền tảng thương mại đóng gói sẵn (Vapi, Retell AI)
Đây là các dịch vụ SaaS cung cấp sẵn toàn bộ hạ tầng Voice Agent kèm dashboard trực quan.
- Ưu điểm: Triển khai nhanh chỉ trong vài giờ, tích hợp sẵn telephony (Twilio/Vonage).
- Nhược điểm: Chi phí định kỳ cao (thường từ $0.05 – $0.15/phút bên cạnh phí API LLM/TTS), bị khóa chặt vào nhà cung cấp (vendor lock-in) và khó can thiệp sâu vào logic nội bộ.
3. Sử dụng Pipecat kết hợp WebRTC
Giải pháp mã nguồn mở cân bằng giữa tốc độ, khả năng tùy biến cao và bài toán tối ưu chi phí vận hành.
Pipecat + WebRTC: Cặp đôi hoàn hảo cho Voice Agent
Pipecat là framework mã nguồn mở viết bằng Python, chuyên dụng để xây dựng các agent tương tác bằng giọng nói và hình ảnh theo thời gian thực.
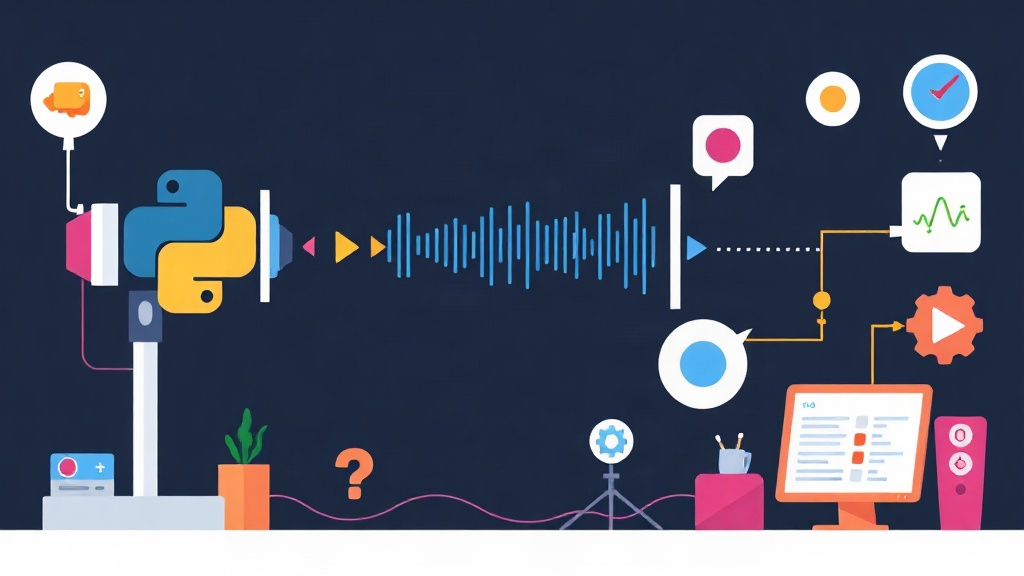
Thay vì xử lý từng file âm thanh cồng kềnh, Pipecat hoạt động như một hệ thống đường ống (pipeline). Âm thanh từ microphone được xé nhỏ thành các frame cực ngắn (khoảng 20-40ms) và chảy liên tục qua các mắt xích:
Microphone → Silero VAD → STT (Streaming) → LLM (Tokens) → TTS (Audio Chunks) → Loa phát
Khi kết hợp cùng WebRTC (thông qua hạ tầng Daily hoặc LiveKit), độ trễ truyền tải tín hiệu âm thanh hai chiều chỉ còn khoảng 50 – 150ms. Đặc biệt, khi người dùng lên tiếng ngắt lời (barge-in), bộ phân tích VAD lập tức gửi tín hiệu hủy (interruption frame) xuống toàn bộ pipeline. Bot ngừng phát loa ngay tức khắc và chuyển sang lắng nghe ý mới mà không bị đơ luồng.
Các bước xây dựng Voice Agent với Pipecat
Bước 1: Chuẩn bị môi trường và thư viện
Khởi tạo môi trường ảo Python 3.10+ và cài đặt Pipecat cùng các plugin:
# Tạo và kích hoạt môi trường ảo
python3 -m venv venv
source venv/bin/activate

# Cài đặt Pipecat cùng các connector
pip install "pipecat-ai[daily,openai,deepgram,silero]" python-dotenv loguru
Tạo file .env lưu thông tin cấu hình API:
DEEPGRAM_API_KEY=your_deepgram_api_key
OPENAI_API_KEY=your_openai_api_key
DAILY_API_KEY=your_daily_api_key
DAILY_SAMPLE_ROOM_URL=https://yourdomain.daily.co/your-room-name
Bước 2: Xây dựng Pipeline xử lý âm thanh
Tạo file bot.py với luồng xử lý không đồng bộ (asyncio):
import os
import sys
import asyncio
from dotenv import load_dotenv
from loguru import logger

from pipecat.audio.vad.silero import SileroVADAnalyzer
from pipecat.pipeline.pipeline import Pipeline
from pipecat.pipeline.runner import PipelineRunner
from pipecat.pipeline.task import PipelineParams, PipelineTask
from pipecat.processors.aggregators.llm_response import (
    LLMAssistantResponseAggregator,
    LLMUserResponseAggregator,
)
from pipecat.services.deepgram import DeepgramSTTService
from pipecat.services.openai import OpenAILLMService, OpenAITTSService
from pipecat.transports.services.daily import DailyParams, DailyTransport

load_dotenv(override=True)

async def main():
    room_url = os.getenv("DAILY_SAMPLE_ROOM_URL")
    token = os.getenv("DAILY_API_KEY")

    if not room_url:
        logger.error("Vui lòng cung cấp DAILY_SAMPLE_ROOM_URL trong file .env")
        sys.exit(1)

    # 1. Khởi tạo Transport WebRTC qua Daily
    transport = DailyTransport(
        room_url,
        token,
        "Voice AI Assistant",
        DailyParams(
            audio_out_enabled=True,
            vad_enabled=True,
            vad_analyzer=SileroVADAnalyzer(),
            vad_audio_passthrough=True,
        ),
    )

    # 2. Khởi tạo các service xử lý thành phần
    stt = DeepgramSTTService(api_key=os.getenv("DEEPGRAM_API_KEY"))

    llm = OpenAILLMService(
        api_key=os.getenv("OPENAI_API_KEY"),
        model="gpt-4o-mini"
    )

    tts = OpenAITTSService(
        api_key=os.getenv("OPENAI_API_KEY"),
        voice="alloy"
    )

    # 3. Cấu hình context hội thoại
    messages = [
        {
            "role": "system",
            "content": "Bạn là trợ lý ảo thân thiện. Hãy trả lời ngắn gọn, tự nhiên trong 1-2 câu.",
        },
    ]

    tcontext = OpenAILLMService.create_context(messages)
    tcontext_aggregator = llm.create_context_aggregator(tcontext)

    # 4. Ghép nối Pipeline
    pipeline = Pipeline([
        transport.input(),                  # Nhận audio stream từ WebRTC
        stt,                                # Audio -> Text (Streaming)
        tcontext_aggregator.user(),          # Thêm text người dùng vào context
        llm,                                # LLM sinh câu trả lời (Tokens)
        tts,                                # Text -> Audio (Chunks)
        transport.output(),                 # Phát audio qua WebRTC
        tcontext_aggregator.assistant(),     # Lưu phản hồi của bot vào context
    ])

    task = PipelineTask(pipeline, PipelineParams(allow_interruptions=True))

    @transport.event_handler("on_first_participant_joined")
    async def on_first_participant_joined(transport, participant):
        transport.capture_participant_transcription(participant["id"])
        # Bot chủ động mở lời chào
        await task.queue_frames([OpenAILLMService.create_context_frame(messages)])

    runner = PipelineRunner()
    logger.info("Voice Bot đang chạy và sẵn sàng kết nối...")
    await runner.run(task)

if __name__ == "__main__":
    asyncio.run(main())
Bước 3: Chạy thử nghiệm và đo kiểm
Chạy ứng dụng từ terminal:
python bot.py
Truy cập vào URL phòng Daily trên trình duyệt, bật micro và trò chuyện trực tiếp. Bot sẽ phản hồi chỉ sau khoảng 500 – 700ms khi bạn vừa dứt câu. Hãy thử ngắt lời khi bot đang nói; bạn sẽ thấy âm thanh dừng ngay trong tích tắc để lắng nghe câu hỏi mới.
Bí quyết tối ưu độ trễ cho môi trường Production
Để đưa Voice Agent từ môi trường thử nghiệm ra phục vụ thực tế, đây là các thông số bạn nên tối ưu:
- Vị trí địa lý máy chủ (Server Region): Nếu người dùng ở Việt Nam, hãy đặt Pipecat server tại Singapore (
ap-southeast-1) để giữ ping WebRTC dưới 35ms. Đặt server ở US sẽ cộng thêm 200ms round-trip không đáng có. - Dùng TTS chuyên biệt cho đàm thoại: Thay vì OpenAI TTS (~350ms TTFB), hãy cân nhắc Cartesia Sonic (~100-140ms) hoặc ElevenLabs Flash v2.5 (~150ms). Trải nghiệm sẽ mượt hơn đáng kể.
- Chọn LLM có tốc độ nhả token đầu cực nhanh (TTFT): Các model như
gpt-4o-minihoặcclaude-3-5-haikucó TTFT dưới 250ms, vượt trội hơn nhiều so với các model 70B tự host không đủ hạ tầng GPU. - Tinh chỉnh ngưỡng ngắt câu VAD: Trong Silero VAD, hãy đặt
stop_secsở mức0.25 - 0.35s. Mức này đủ nhạy để nhận diện kết thúc câu mà không ngắt nhầm khi người dùng chỉ tạm dừng lấy hơi.