Bối cảnh: Khi vòng lặp for trở thành nút thắt cổ chai
Nếu từng viết một script Python gọi API cho 500 khách hàng bằng vòng lặp for tuần tự, bạn sẽ thấm thía cảm giác chờ đợi. Mình từng mất hơn 15 phút chỉ để chạy xong một tác vụ như vậy. Đáng nói là CPU lúc đó gần như nhàn rỗi (mức sử dụng dưới 2%). Phần lớn thời gian tiến trình chỉ dán mắt chờ server đầu bên kia trả kết quả.
Ở một trường hợp khác, mình cần giải nén và băm mã SHA-256 cho hàng nghìn file log. Lần này CPU nhảy vọt lên 100%, nhưng chỉ trên đúng một nhân. Bảy nhân còn lại của máy chủ hoàn toàn đắp chiếu.
Hai vấn đề trên đại diện cho hai nhóm bài toán kinh điển trong lập trình:
- I/O Bound (Nghẽn vào/ra): Tác vụ tốn phần lớn thời gian chờ mạng, đọc/ghi đĩa cứng hoặc đợi query từ cơ sở dữ liệu. CPU không cần tính toán nhiều.
- CPU Bound (Nghẽn tính toán): Tác vụ đòi hỏi CPU làm việc liên tục như mã hóa dữ liệu, nén ảnh, xử lý ma trận hay huấn luyện mô hình máy học.
CPython có cơ chế Global Interpreter Lock (GIL). Khóa này ngăn các thread chạy mã bytecode Python đồng thời trên nhiều lõi CPU vật lý. Do đó, đa luồng trong Python không giúp tăng tốc tính toán nặng. Tuy nhiên, khi một thread gặp tác vụ I/O (như gửi HTTP request), nó sẽ chủ động nhả GIL cho thread khác chạy tiếp.
Trước đây, lập trình viên phải xoay xở thủ công với module threading hoặc multiprocessing. Việc tự quản lý Queue, bắt exception giữa các tiến trình hay tránh deadlock rất dễ phát sinh lỗi.
Từ Python 3.2, module concurrent.futures ra đời để giải quyết bài toán này. Nó cung cấp một giao diện cấp cao đồng nhất, quản lý Worker Pool tự động và gom kết quả qua đối tượng Future rất gọn gàng.
Cài đặt môi trường thử nghiệm
Module concurrent.futures được tích hợp sẵn trong Python Standard Library, bạn không cần cài thêm. Để tiện thực hành đo đạc benchmark trong bài, chúng ta cài thêm thư viện requests và tqdm:
# Tạo và kích hoạt virtual environment
python3 -m venv venv
source venv/bin/activate  # Trên Windows: venv\Scripts\activate

# Cài đặt thư viện hỗ trợ gọi mạng và vẽ thanh tiến trình
pip install requests tqdm
ThreadPoolExecutor vs ProcessPoolExecutor: Dùng cái nào?
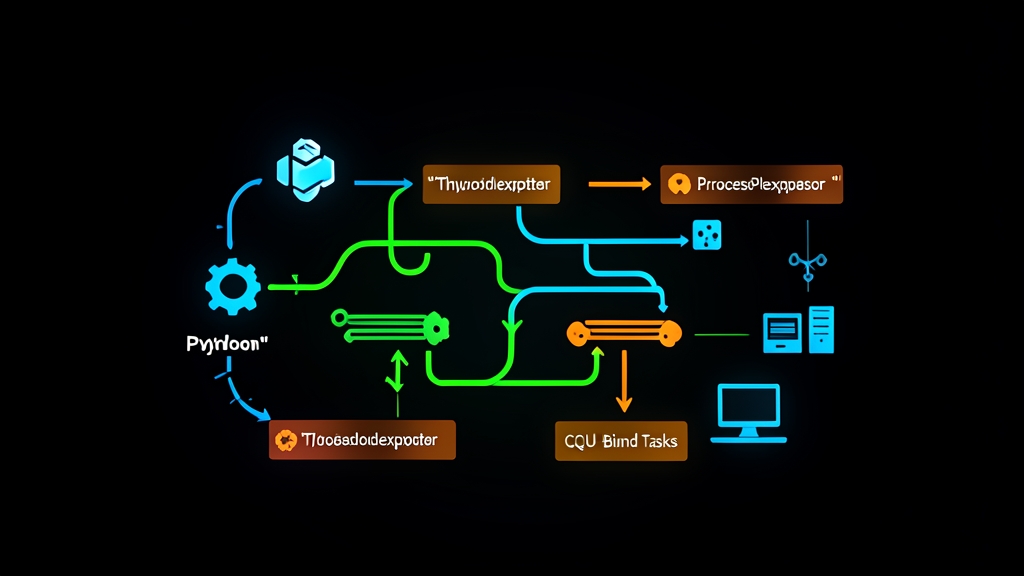
Module cung cấp hai lớp thực thi chính kế thừa từ Executor. Chọn đúng công cụ cho bài toán sẽ quyết định script chạy nhanh hay chậm.
1. Xử lý tác vụ I/O Bound với ThreadPoolExecutor
ThreadPoolExecutor phù hợp cho các tác vụ như tải file, cào dữ liệu web hay gọi webhook. Các thread dùng chung không gian bộ nhớ của process cha nên chi phí khởi tạo rất thấp.
Thông số quan trọng nhất là max_workers. Từ Python 3.8, giá trị mặc định được tính bằng min(32, (os.cpu_count() or 1) + 4). Với tác vụ chờ phản hồi HTTP có độ trễ cao, bạn có thể tăng con số này lên 20–50 workers, miễn là không vượt quá rate limit của server đích.
Phương thức submit() kết hợp với as_completed() cho phép bạn lấy kết quả ngay khi một worker vừa hoàn tất, không cần đợi cả danh sách:
import time
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed

URLS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/2",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/status/404",
    "https://httpbin.org/delay/1",
]

def fetch_url(url, timeout=5):
    response = requests.get(url, timeout=timeout)
    return url, response.status_code

start_time = time.perf_counter()

# Khởi tạo pool với 5 luồng chạy song song
with ThreadPoolExecutor(max_workers=5) as executor:
    future_to_url = {executor.submit(fetch_url, url): url for url in URLS}

    for future in as_completed(future_to_url):
        url = future_to_url[future]
        try:
            target_url, status = future.result()
            print(f"[Xong] {target_url} -> HTTP {status}")
        except Exception as exc:
            print(f"[Lỗi] {url} gặp ngoại lệ: {exc}")

elapsed = time.perf_counter() - start_time
print(f"Thời gian thực thi: {elapsed:.2f} giây")
Nếu chạy tuần tự, bạn tốn ít nhất 1 + 2 + 1 + 0.1 + 1 ≈ 5.1 giây. Khi chạy song song bằng 5 workers, tổng thời gian rút xuống chỉ còn khoảng 2.1 đến 2.3 giây, xấp xỉ thời gian của request có độ trễ lớn nhất.
2. Phá vỡ rào cản GIL với ProcessPoolExecutor cho CPU Bound
Khi cần băm mật mã, nén file hay xử lý ảnh, đa luồng thông thường vô tác dụng vì GIL. ProcessPoolExecutor giải quyết việc này bằng cách tách thành nhiều process độc lập. Mỗi process có một Python interpreter và vùng nhớ riêng, khai thác được 100% tài nguyên của từng nhân CPU.
Lưu ý: Nên đặt max_workers bằng số nhân thực tế (os.cpu_count()). Đặt quá nhiều process sẽ gây phản tác dụng do hệ điều hành tốn tài nguyên chuyển đổi ngữ cảnh (context switching) và truyền dữ liệu liên tiến trình (IPC).
import hashlib
import os
import time
from concurrent.futures import ProcessPoolExecutor

def heavy_hashing_task(number):
    """Giả lập tác vụ nặng tiêu tốn chu kỳ CPU."""
    data = str(number).encode('utf-8')
    for _ in range(2_000_000):
        data = hashlib.sha256(data).digest()
    return number, data.hex()[:10]

# Bắt buộc dùng __main__ để tránh lỗi fork lặp vô hạn trên Windows/macOS
if __name__ == '__main__':
    numbers = [10001, 10002, 10003, 10004, 10005, 10006, 10007, 10008]
    cores = os.cpu_count() or 4
    print(f"Hệ thống phát hiện: {cores} nhân CPU")

    start_time = time.perf_counter()

    with ProcessPoolExecutor(max_workers=cores) as executor:
        results = list(executor.map(heavy_hashing_task, numbers))

    for num, hashed in results:
        print(f"Giá trị {num} -> Hash: {hashed}")

    print(f"Hoàn tất sau: {time.perf_counter() - start_time:.2f} giây")
Quản lý lỗi và Giám sát tiến độ
Đưa code chạy song song vào hệ thống thực tế đòi hỏi cơ chế ngắt lỗi chặt chẽ. Nếu không kiểm soát, một worker bị treo có thể làm tê liệt cả tiến trình.
1. Thiết lập Timeout chủ động
Mặc định, lệnh future.result() sẽ block chương trình cho đến khi task chạy xong. Hãy luôn gán giá trị timeout để tránh việc chờ đợi vô thời hạn:
from concurrent.futures import TimeoutError

try:
    # Giới hạn tối đa 3 giây cho task này
    result = future.result(timeout=3)
except TimeoutError:
    print("Task chạy quá 3 giây, bỏ qua kết quả!")
    # cancel() chỉ hủy được nếu task vẫn đang xếp hàng chờ, chưa bắt đầu chạy
    future.cancel()
2. Theo dõi tiến độ với tqdm
Khi xử lý hàng nghìn records, việc in log liên tục ra terminal rất khó theo dõi. Bạn có thể bọc as_completed bên trong tqdm để tạo thanh tiến trình trực quan:
from tqdm import tqdm

with ThreadPoolExecutor(max_workers=8) as executor:
    futures = [executor.submit(fetch_url, url) for url in URLS]

    for f in tqdm(as_completed(futures), total=len(futures), desc="Đang xử lý request"):
        try:
            res = f.result()
        except Exception as err:
            pass
3. Bảng tóm tắt nguyên tắc sử dụng
- I/O Bound (API, Network, Disk): Chọn
ThreadPoolExecutor. Thiết lậpmax_workerstừ 10 đến 32 tùy hạ tầng. - CPU Bound (Mã hóa, Xử lý ảnh): Chọn
ProcessPoolExecutor. Đặtmax_workersbằng số core CPU của máy. - Khả năng tuần tự hóa (Pickle): Mọi tham số và hàm truyền vào
ProcessPoolExecutorbắt buộc phải pickle được. Tuyệt đối không truyền các object như file descriptor, socket hay connection database mở vào process con. - Dọn dẹp tài nguyên: Luôn dùng khối
with. Khi thoát ra ngoài, context manager sẽ tự động gọiexecutor.shutdown(wait=True), tránh rò rỉ tài nguyên hệ thống.