Vấn đề thực tế: MySQL quá tải khi dữ liệu phình to
Khi bảng products chạm mốc 500.000 bản ghi, bài toán tìm kiếm bắt đầu phát sinh vấn đề. Khách hàng thường gõ từ khóa không dấu, gõ sai chính tả hoặc lọc đồng thời 4-5 tiêu chí: danh mục, khoảng giá, đánh giá và tồn kho.
Nếu bạn vẫn dùng MySQL với câu lệnh LIKE '%keyword%' kèm 3-4 lệnh JOIN, CPU máy chủ database sẽ nhanh chóng chạm ngưỡng 100%. Thời gian phản hồi từ 50ms có thể vọt lên 3-5 giây. Kết quả là toàn bộ connection pool bị nghẽn, kéo theo API tạo đơn hàng và thanh toán cũng tê liệt.
Vì sao MySQL đuối sức trước bài toán Full-Text Search?
Có 3 lý do kỹ thuật khiến MySQL không phù hợp để gánh tải tìm kiếm nâng cao:
- B-Tree Index không hỗ trợ wildcard ở đầu chuỗi: MySQL tối ưu tuyệt đối cho tìm kiếm chính xác hoặc tiền tố (
LIKE 'iphone%'). Khi bạn đặt ký tự%ở đầu (LIKE '%iphone%'), index hoàn toàn vô tác dụng. MySQL buộc phải quét toàn bộ bảng (Full Table Scan). - Tranh chấp tài nguyên đọc – ghi: MySQL sinh ra để phục vụ giao dịch OLTP (giao dịch ACID). Việc bắt database vừa tính điểm độ liên quan (scoring) vừa xử lý ghi chép đơn hàng sẽ làm tăng nguy cơ lock bảng và đẩy I/O đĩa lên mức báo động.
- Kiến trúc Inverted Index của Elasticsearch: Elasticsearch tách nhỏ văn bản thành các token riêng biệt và lập chỉ mục đảo. Khi tìm từ khóa, hệ thống chỉ cần tra bảng từ khóa để lấy danh sách Document ID tương ứng. Tốc độ phản hồi thường dưới 30ms, ngay cả trên tập dữ liệu hàng chục triệu dòng.
3 hướng tiếp cận đồng bộ dữ liệu phổ biến
Tùy theo quy mô hệ thống, bạn có thể chọn một trong các cách sau:
- Dual-Write ở tầng Application: Mỗi khi thêm hoặc sửa trên MySQL, code backend tự bắn event qua RabbitMQ hoặc Kafka để cập nhật sang Elasticsearch. Cách này cập nhật gần như tức thì. Tuy nhiên, logic code trở nên cồng kềnh và rất dễ lệch dữ liệu khi service gặp sự cố mạng.
- Change Data Capture (CDC) với Debezium: Giải pháp đọc trực tiếp MySQL binlog. Cách này cực kỳ chuẩn xác và đáp ứng realtime. Đổi lại, chi phí hạ tầng và công sức vận hành khá cao, chỉ thực sự đáng giá với các hệ thống Microservices lớn.
- Dùng Logstash với JDBC Input Plugin: Logstash đóng vai trò worker trung gian, định kỳ query các bản ghi mới hoặc vừa chỉnh sửa từ MySQL rồi đẩy sang Elasticsearch.
Giải pháp thực dụng: Pipeline tự động với Logstash JDBC
Với phần lớn ứng dụng vừa và nhỏ (dưới vài triệu bản ghi), Logstash JDBC là lựa chọn cân bằng nhất. Bạn không cần sửa một dòng code backend nào, cấu hình tập trung và triển khai chỉ mất khoảng 30 phút.
Dưới đây là quy trình 4 bước thiết lập thực tế.
Bước 1: Chuẩn bị bảng dữ liệu trên MySQL
Để Logstash biết bản ghi nào cần đồng bộ mà không phải scan lại cả triệu dòng, bảng bắt buộc phải có cột updated_at kèm Index.
CREATE DATABASE IF NOT EXISTS shop_db;
USE shop_db;

CREATE TABLE products (
    id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(255) NOT NULL,
    description TEXT,
    price DECIMAL(10, 2) NOT NULL,
    is_deleted TINYINT(1) DEFAULT 0,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
    INDEX idx_updated_at (updated_at)
);

-- Thêm dữ liệu mẫu
INSERT INTO products (title, description, price) VALUES
('Bàn phím cơ không dây', 'Layout 75%, kết nối Bluetooth và 2.4GHz', 1500000),
('Chuột gaming công thái học', 'Trọng lượng 60g, cảm biến 26000 DPI', 850000),
('Màn hình 27 inch 4K IPS', 'Độ phủ màu 100% sRGB, chuyên đồ họa', 7200000);
Bước 2: Tải MySQL Connector/J (JDBC Driver)
Logstash cần driver JDBC để giao tiếp với MySQL. Tải file .jar về máy chủ Logstash:
# Tạo thư mục chứa driver
sudo mkdir -p /etc/logstash/drivers
cd /etc/logstash/drivers

# Tải MySQL Connector/J (phiên bản 8.0.33)
sudo wget https://repo1.maven.org/maven2/mysql/mysql-connector-java/8.0.33/mysql-connector-java-8.0.33.jar
Bước 3: Cấu hình pipeline trong Logstash
Tạo file cấu hình tại /etc/logstash/conf.d/mysql_to_es.conf:
input {
  jdbc {
    jdbc_driver_library => "/etc/logstash/drivers/mysql-connector-java-8.0.33.jar"
    jdbc_driver_class => "com.mysql.cj.jdbc.Driver"
    jdbc_connection_string => "jdbc:mysql://localhost:3306/shop_db?useSSL=false&serverTimezone=UTC"
    jdbc_user => "db_user"
    jdbc_password => "Secret_Password_123"

    # Chu kỳ chạy: mỗi 1 phút
    schedule => "* * * * *"

    # Theo dõi mốc thời gian cập nhật
    use_column_value => true
    tracking_column => "updated_at"
    tracking_column_type => "timestamp"
    last_run_metadata_path => "/var/lib/logstash/.logstash_products_last_run"

    # Chỉ lấy dữ liệu mới hơn mốc chạy gần nhất
    statement => "SELECT id, title, description, price, is_deleted, updated_at FROM products WHERE updated_at > :sql_last_value ORDER BY updated_at ASC"
  }
}

filter {
  mutate {
    remove_field => ["@version", "@timestamp"]
  }
}

output {
  elasticsearch {
    hosts => ["http://localhost:9200"]
    index => "products"
    document_id => "%{id}"
    action => "index"
  }

  # In log ra console để debug khi cần
  stdout {
    codec => rubydebug
  }
}
Bước 4: Khởi động và kiểm tra pipeline
Trước tiên, hãy kiểm tra tính hợp lệ của file cấu hình:
# Kiểm tra cú pháp cấu hình
sudo /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/mysql_to_es.conf --config.test_and_exit

# Khởi chạy service Logstash
sudo systemctl start logstash
sudo systemctl enable logstash
Sau khoảng 1 phút, kiểm tra dữ liệu đã vào Elasticsearch bằng lệnh cURL:
curl -X GET "http://localhost:9200/products/_search?pretty" -H 'Content-Type: application/json' -d'
{
  "query": {
    "match": {
      "title": "bàn phím cơ"
    }
  }
}'
Lưu ý thực chiến khi vận hành
Pipeline chạy ổn định trong môi trường test chưa đảm bảo mọi thứ sẽ trơn tru trên production. Dưới đây là 3 điểm bạn cần lưu ý kỹ:
- Xử lý xóa dữ liệu (Hard Delete vs Soft Delete): Logstash chạy câu lệnh
SELECTđịnh kỳ nên sẽ không bắt được các bản ghi đã bịDELETEcứng. Do đó, hãy dùng cơ chế Soft Delete (đánh dấuis_deleted = 1). Trên Elasticsearch, bạn chỉ cần lọc bỏ các document có cờ này khi truy vấn. - Đồng bộ Timezone: Luôn thống nhất UTC giữa MySQL, máy chủ Linux và Logstash. Tham số
serverTimezone=UTCtrên JDBC connection string là bắt buộc để tránh tình trạng lệch giờ khiến:sql_last_valuebỏ sót dữ liệu. - Giữ MySQL làm nguồn chuẩn (Single Source of Truth): Elasticsearch chỉ đóng vai trò bộ nhớ đệm phục vụ tìm kiếm. Đừng bao giờ đọc trực tiếp dữ liệu từ Elasticsearch để xử lý nghiệp vụ thanh toán hay trừ kho. Hãy duy trì cơ chế backup MySQL định kỳ và định nghĩa rõ ràng luồng dữ liệu chính – phụ.
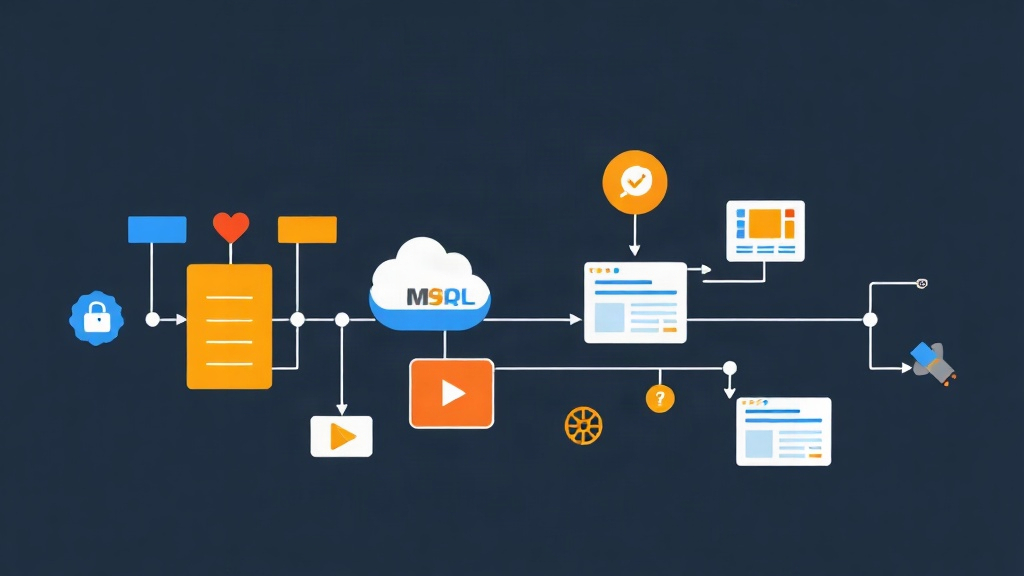
Mô hình MySQL kết hợp Elasticsearch qua Logstash giúp bạn tận dụng tối đa tốc độ tìm kiếm vượt trội của Elasticsearch mà vẫn giữ được tính nhất quán và đơn giản của kiến trúc ứng dụng.