なぜRAGチャットボットは的外れな回答をしてしまうのか?
社内FAQやドキュメント検索のチャットボットに質問した際、まったく見当違いな回答が返ってきた経験はないでしょうか?この問題の原因は、AIモデルの性能不足であることは稀で、多くはドキュメントの分割処理(チャンキング)にあります。
全50ページの財務報告書があると想像してみてください。それをハサミで約200文字ずつの断片に細かく切り刻み、箱の中に放り込みます。そこで上司から「今期の小売部門の売上成長率は?」と聞かれ、手探りで引き当てた紙切れにこう書かれていたとします。「当部門は、代理店網の拡大により前年同期比18%の増収を達成した。」
この紙切れには会社名も会計年度も書かれていません。「当部門」が小売なのか卸売なのかすら不明です。従来のRAG(Retrieval-Augmented Generation)システムは、まさにこれと同じ挙動をしています。元ドキュメントの文脈が失われているため、LLMは推測に頼るか、別の部門の情報を誤って結びつけてしまうのです。
Contextual Retrievalはどのようにこの課題を解決するのか?
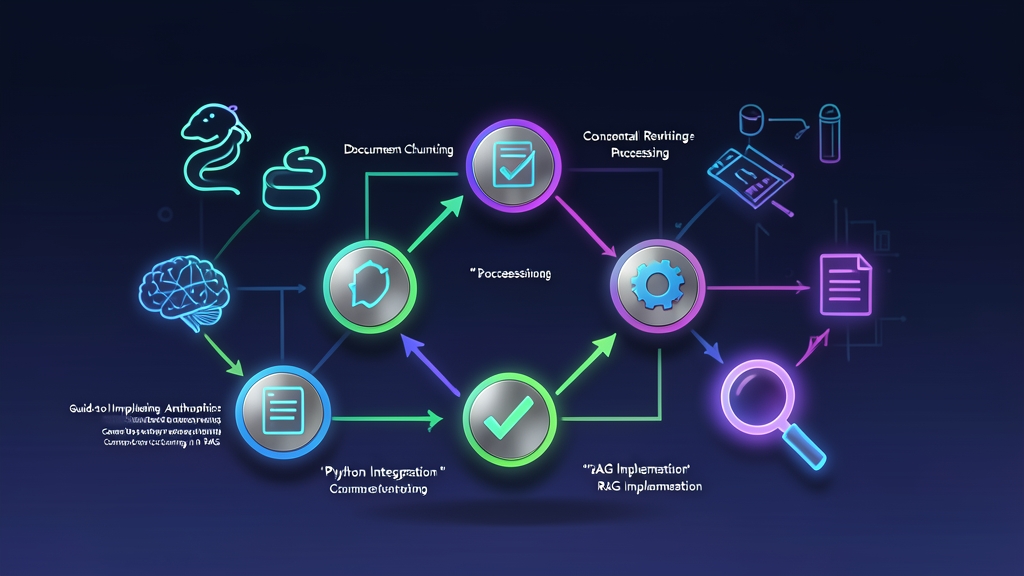
2024年9月、Anthropicはこの課題を根本から解決するContextual Retrievalという手法を発表しました。そのコンセプトは極めてシンプルで、「文脈のない孤立したテキスト断片を決して保存しない」というものです。
ベクトルデータベースへデータを投入する前に、Claude 3 Haikuのような軽量・高速なモデルを用いてドキュメント全体を読み込ませます。そして、各チャンクの先頭に、その位置づけを補足する短い説明文(50〜100語程度)を自動付与します。
これにより、先ほどの断片的な紙切れは次のように生まれ変わります。
「本抜粋はFPTリテール株式会社の2024年度第3四半期財務報告書、FPT Shopチェーンの業績セクションに含まれるものです。当部門は、代理店網の拡大により前年同期比18%の増収を達成した…」
これで文脈が一目瞭然になりました。ベクトル検索(Embedding)でもキーワード検索(BM25)でも、目的のチャンクを容易にヒットさせることができます。Anthropicのベンチマークによると、Contextual EmbeddingsとBM25を組み合わせることで、検索失敗率(ドキュメント取得ミス)を49%削減できるとされています。さらにReranking(Cohere Rerankなど)を追加した場合、失敗率は最大67%も削減されます。
実践:PythonによるContextual Retrievalの実装
社内契約書ドキュメントで検証したところ、検索フェーズの精度が劇的に向上しました。以下に、Anthropic SDKとChromaDBを使用した完全な実装サンプルを紹介します。
ステップ1:環境構築
pip install anthropic chromadb
ステップ2:Prompt Cachingを活用した文脈生成関数の作成
数十ページに及ぶドキュメントにおいて、チャンクごとに毎回ドキュメント全体をAPI送信していては、コストが跳ね上がってしまいます。ここで重要になるのがPrompt Cachingです。元ドキュメントをキャッシュ対象として指定することで、以降のチャンク処理における入力トークンコストを約90%削減できます。
import os
from anthropic import Anthropic

client = Anthropic(api_key=os.environ.get("ANTHROPIC_API_KEY"))

def generate_context_prefix(document_text: str, chunk_text: str) -> str:
    """
    Claude 3 Haikuを使用して、チャンクの位置づけを要約した1〜2文の文脈を生成します。
    cache_controlによるPrompt Cachingを活用し、コストとレイテンシを最適化します。
    """
    response = client.messages.create(
        model="claude-3-haiku-20240307",
        max_tokens=150,
        temperature=0.0,
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "type": "text",
                        "text": f"<document>\n{document_text}\n</document>",
                        # チャンク間で再利用できるよう元ドキュメントをキャッシュ指定
                        "cache_control": {"type": "ephemeral"}
                    },
                    {
                        "type": "text",
                        "text": (
                            f"以下はドキュメントからの抜粋です:\n<chunk>\n{chunk_text}\n</chunk>\n\n"
                            "この抜粋がドキュメント全体のどの部分に属し、何について言及しているかを説明する簡潔な文脈(1〜2文)を提供してください。"
                            "前置きは含めず、文脈の説明のみを出力してください。"
                        )
                    }
                ]
            }
        ]
    )
    return response.content[0].text.strip()
ステップ3:文脈プレフィックスの結合とChromaDBへの登録
生成したプレフィックスを元のチャンクの先頭に連結した上で、ベクトル埋め込み(Embedding)を作成します。
import chromadb

chroma_client = chromadb.Client()
collection = chroma_client.create_collection(name="kb_alpha")

document = """
株式会社アルファテクノロジー - 2024年度年次報告書
第1章:事業概要
アルファ社は「クラウドコンピューティング」と「人工知能(AI)ソリューション」の2大事業に注力しています。
第2章:AI事業の業績
同事業の2024年度売上高は45%の成長を記録し、1,200億ドンに達しました。
第3章:2025年度採用計画
ダナン支社においてAIエンジニア50名の追加採用を予定しています。
"""

# 元ドキュメントから抽出された2つのチャンク
chunks = [
    "同事業の2024年度売上高は45%の成長を記録し、1,200億ドンに達しました。",
    "ダナン支社においてAIエンジニア50名の追加採用を予定しています。"
]

for i, chunk in enumerate(chunks):
    prefix = generate_context_prefix(document_text=document, chunk_text=chunk)
    contextual_chunk = f"{prefix}\n\n{chunk}"

    print(f"=== 文脈付与後のチャンク {i+1} ===")
    print(contextual_chunk)
    print("-" * 40)

    collection.add(
        documents=[contextual_chunk],
        metadatas=[{"original_text": chunk, "source": "Bao_cao_Alpha_2024.pdf"}],
        ids=[f"chunk_{i}"]
    )
ステップ4:検索精度の検証
実際の質問クエリを投げてテストしてみましょう。
query = "アルファ社のAI事業の売上成長率はどれくらいですか?"
results = collection.query(query_texts=[query], n_results=1)

print("最もマッチしたチャンク:")
print(results["documents"][0][0])
プレフィックスがない場合、元の文には「同事業」としか書かれていません。検索クエリに含まれる極めて重要なキーワード「AI」や「アルファ」が欠落しているため、通常のベクトル検索では見落とされてしまうリスクが非常に高くなります。
どのようなユースケースに適用すべきか?
このアプローチの大きなメリットは、既存の検索基盤をスクラップ&ビルドする必要がない点です。データ取り込み(ingestion)パイプラインに、文脈補完のエンリッチメントステップを1つ追加するだけで導入できます。
- 実運用コスト: AnthropicのPrompt Cachingを利用すれば、Claude 3 Haikuによる100万入力トークンの処理コストは約0.30米ドル(約45円)に抑えられます。チャットボットのハルシネーション(幻覚)対応やデバッグに費やす工数と比較すれば、極めて低コストです。
- 推奨される適用先: 業務委託契約書、APIリファレンス、医療カルテ、財務諸表などに特に効果的です。これらは「甲/乙」「本条項」「これ」といった曖昧な指示代名詞が頻出するためです。
- 不要なケース: 短文のQ&Aデータセット、独立したFAQ集、各セクションが明確に自己完結しているWiki記事などであれば、従来のシンプルなチャンキングでも十分機能します。