現場のリアル:午前2時の悪夢と「502 Bad Gateway」
夜8時のリリース後はすべてが順調に見えました。トラフィックは安定し、注文も順調に伸びていました。しかし深夜2時、緊急アラートの通知がけたたましく鳴り響きます。アプリケーション全体が「502 Bad Gateway」で停止。慌ててノートPCを開きターミナルを確認すると、チェックアウト処理を担っていたコンテナが跡形もなく消え去っていました。
約15個のmicroservicesで構成されたECプロジェクトで、私は丸2日間メモリリーク(memory leak)の調査に忙殺された経験があります。4〜6時間ごとにサーバーのRAM(8GB)が98%まで食い尽くされるのです。その場しのぎの解決策といえば、コンテナを手動で再起動して一時的に息を吹き返させることだけでした。しかし数時間後には、まったく同じ悪夢が繰り返されます。メトリクスの計測データがないため、チーム全員が暗闇の中を手探りで進むような状態で、Node.jsのコードからPostgreSQLのクエリまで当て推量で調べたものの、どこでリソースが消失しているのか特定できませんでした。
原因の分析:なぜDocker環境は「ブラックボックス化」しやすいのか?
Dockerをオートロック付きの集合住宅に例えてみましょう。各コンテナは完全に独立した一室です。エントランス(つまりホストサーバー)に立っている管理者からは、建物全体で100kWの電力を消費していることしか分からず、どの部屋がエアコンを16度に設定してブレーカーを落とす原因になっているのかまでは分かりません。
コンテナ運用において状況の把握を困難にする3大障壁があります:
- 履歴データの欠如: 標準的なコマンドでは現在の瞬間値しか確認できません。障害が発生した後では、15分前にどのコンテナが突如CPU使用率100%に達していたのかを振り返る術がありません。
- コンテナの分散と増加: 一般的なmicroservicesアーキテクチャでは、10〜30個ものプロセス(Web、キャッシュ、キューワーカー、データベースなど)が同時に稼働しています。これらを手作業で1つずつ確認するのは現実的ではありません。
- サイレントキル: メモリ上限に達すると、Linuxカーネルのプロセス(OOM Killer)が事前の警告なしにコンテナを即座に強制終了(kill)してしまいます。
現在よく用いられているアプローチ
本格的な監視スタックを構築する前に、多くのエンジニアはまず次の2つの方法を検討します:
アプローチ1:docker stats コマンドによる手動監視
誰もが最初に思いつく最も手軽な方法です:
docker statsターミナル上にCPU、RAM、ネットワークI/Oの数値がリアルタイムに激しく更新されます。しかし最大の弱点は、その黒い画面を常に見張り続けなければならない点です。ターミナルを閉じればデータはすべて消滅し、時間帯別や週単位で負荷の推移を評価できるグラフも残りません。
アプローチ2:SaaS型監視サービス(Datadog、New Relic)の導入
これらのプラットフォームは極めて優れたユーザー体験を提供します。agentをインストールするだけで、洗練されたWebダッシュボードが自動的にセットアップされます。
しかし、コスト面が大きな障壁となります。例えばDatadogの場合、監視ホスト1台につき月額15〜23米ドル程度からスタートし、メトリクスやログの従量課金も加算されます。中小規模のプロジェクトでは、監視サービスの請求額がVPSのサーバー費用自体の2倍に跳ね上がることも珍しくありません。
最適なソリューション:Docker Composeで連携する cAdvisor + Prometheus + Grafana
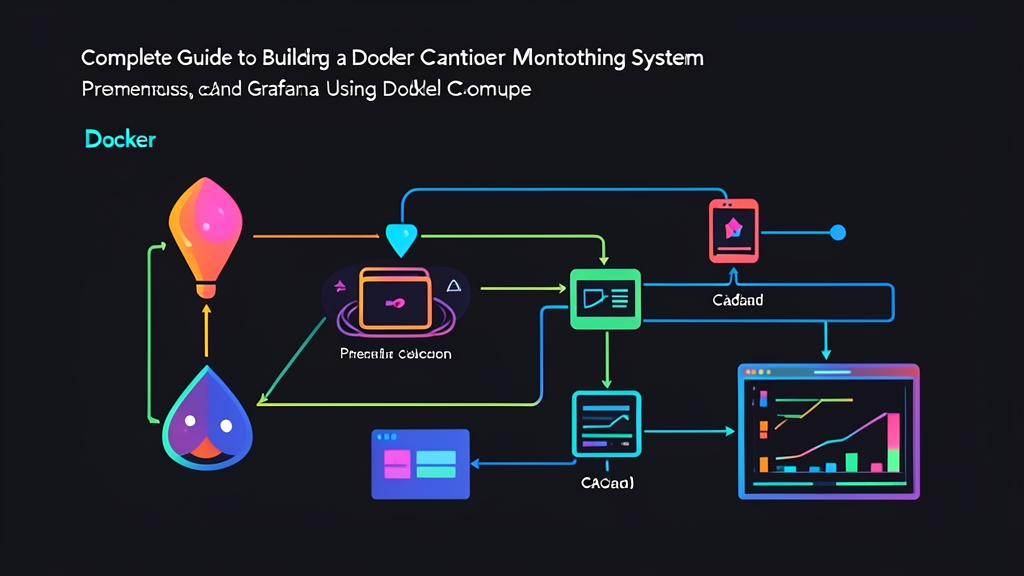
コストとパフォーマンスのバランスが最も優れているのは、既存のインフラ上でオープンソースのスタックを自前構築することです。以下の3つのツールが連携し、完結した監視サイクルを実現します:
- cAdvisor(メトリクス収集): LinuxのcgroupsやDockerデーモンから直接情報を取得し、コンテナごとのCPU、RAM、ネットワーク、ディスクI/Oの使用状況をリアルタイムに詳細計測します。
- Prometheus(時系列データベース): cAdvisorから定期的にメトリクスをプル(pull)し、高度に最適化された時系列データベース(TSDB)へ保存します。
- Grafana(可視化): Prometheusに保存されたデータを読み出し、無機質な数値データを直感的なダッシュボードに変換します。異常を検知した際のアラート通知(alerting)設定も可能です。
ステップ1:Prometheus設定ファイルの作成
cAdvisorからメトリクスを収集するエンドポイントを指定するため、prometheus.ymlを作成します:
global:
  scrape_interval: 5s

scrape_configs:
  - job_name: 'cadvisor'
    static_configs:
      - targets: ['cadvisor:8080']
ステップ2:docker-compose.ymlの作成
prometheus.ymlと同じディレクトリに、以下の内容でdocker-compose.ymlを配置します:
version: '3.8'

services:
  cadvisor:
    image: gcr.io/cadvisor/cadvisor:v0.49.1
    container_name: monitoring-cadvisor
    restart: unless-stopped
    privileged: true
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker/:/var/lib/docker:ro
      - /dev/disk/:/dev/disk:ro
    expose:
      - 8080
    networks:
      - monitoring-net

  prometheus:
    image: prom/prometheus:v2.51.0
    container_name: monitoring-prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prometheus_data:/prometheus
    ports:
      - "9090:9090"
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.path=/prometheus'
    networks:
      - monitoring-net

  grafana:
    image: grafana/grafana:10.4.0
    container_name: monitoring-grafana
    restart: unless-stopped
    ports:
      - "3000:3000"
    environment:
      - GF_SECURITY_ADMIN_USER=admin
      - GF_SECURITY_ADMIN_PASSWORD=adminpass
    volumes:
      - grafana_data:/var/lib/grafana
    networks:
      - monitoring-net

volumes:
  prometheus_data:
  grafana_data:

networks:
  monitoring-net:
    driver: bridge
ステップ3:コンテナの起動とダッシュボードの設定
次のコマンド1つで、監視スタック全体をバックグラウンド起動します:
docker compose up -dGrafanaでのダッシュボード設定手順は非常にシンプルです:
- ブラウザを開き、
http://SERVER_IP:3000にアクセスして初期アカウントadmin / adminpassでログインします。 - Connections > Data Sources へ移動し、Prometheus を選択して、内部URLに
http://prometheus:9090を入力後、Save & test をクリックします。 - Dashboards > Import を開き、テンプレートID
14282(コミュニティで広く使われているcAdvisor向け最適化ダッシュボード)を入力します。
設定が完了すると、美麗なダッシュボードが即座に表示されます。コンテナごとのCPU使用率、実際のRAM消費量、ディスクの読み書き速度、ネットワークトラフィックが明確にグラフ化されます。これがあれば、2〜3時間のメモリ消費グラフの傾きを確認するだけで、サーバーがOOMで停止する前にメモリリークの兆候を確実に検知できます。