Vì sao ClickHouse chạy nhanh nhưng vẫn cần giám sát chặt?
ClickHouse có thể quét hàng trăm triệu bản ghi mỗi giây nhẹ như không. Nhưng khi đưa vào production ở quy mô 500 triệu đến vài tỷ log/ngày, bài toán vận hành bắt đầu phát sinh điểm nghẽn. Chỉ một sơ suất nhỏ cũng đủ khiến server đứng hình:
- Query thiếu filter "nuốt" sạch RAM: Một dev lỡ tay chạy
GROUP BYtrên cột high-cardinality mà quên chặnWHERE date >= today(). Kết quả: tiến trình gặm sạch 64GB RAM sau 5 giây. Linux OOM Killer lập tức can thiệp và hạ sát tiến trình ClickHouse. - Part Mutations dồn toa: ClickHouse xử lý
ALTER UPDATE/DELETEqua cơ chế mutation bất đồng bộ và viết lại toàn bộ data part. Chạy mutation liên tục sẽ khiến disk I/O chạm trần 100%, kéo theo hàng loạt query đọc dữ liệu bị timeout. - Lỗi quá tải part ("Too many parts in all data parts in table"): Nếu ứng dụng insert batch quá nhỏ (như 100 record/lần thay vì gom 50.000 record), ClickHouse sẽ sinh ra cả nghìn file rác. Background merge làm không kịp. Database lập tức chặn mọi request ghi mới để tự bảo vệ.
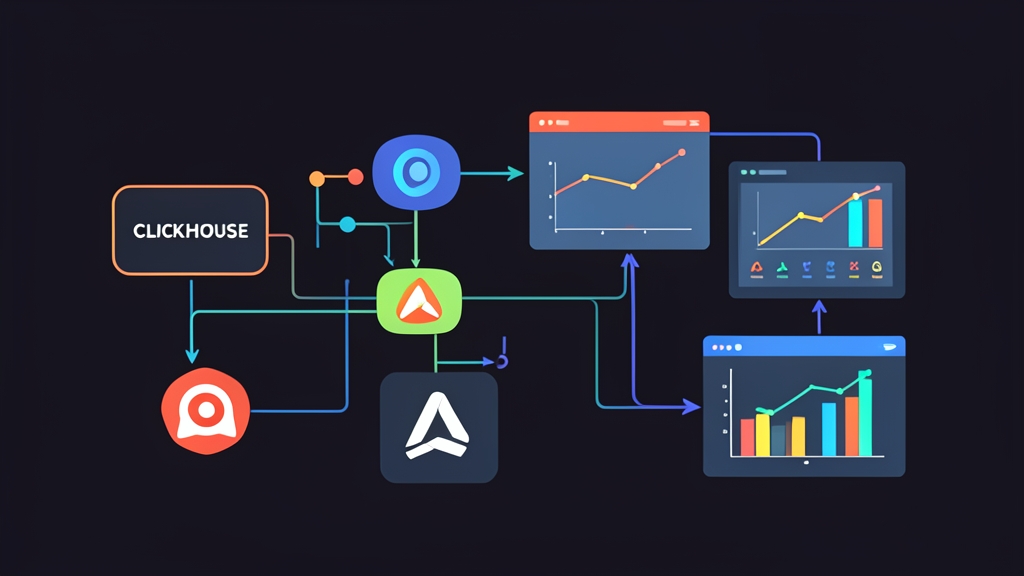
Trước đây, mỗi lần incident xảy ra, team thường phải SSH vào node gõ clickhouse-client rồi query bảng system.processes trong hoảng loạn. Giờ đây, chỉ cần tận dụng OpenMetrics endpoint có sẵn trong core ClickHouse là Prometheus đã có thể kéo dữ liệu về liên tục.
Dựng môi trường thực nghiệm với Docker Compose
Nếu server staging hoặc production của bạn đã chạy sẵn ClickHouse, hãy lướt thẳng tới phần cấu hình XML bên dưới. Còn nếu muốn test nhanh cơ chế scrape metrics, bạn dựng cụm container này trong 2 phút:
# Tạo thư mục làm việc
mkdir -p ~/clickhouse-monitor && cd ~/clickhouse-monitor

# Tạo file docker-compose.yml
cat << 'EOF' > docker-compose.yml
version: '3.8'
services:
  clickhouse:
    image: clickhouse/clickhouse-server:23.8
    container_name: clickhouse-server
    ports:
      - "8123:8123"   # HTTP interface
      - "9000:9000"   # Native TCP client
      - "9363:9363"   # Prometheus metrics port
    volumes:
      - ./ch-config.xml:/etc/clickhouse-server/config.d/prometheus.xml:ro
      - ch_data:/var/lib/clickhouse
    ulimits:
      nofile:
        soft: 262144
        hard: 262144

  prometheus:
    image: prom/prometheus:v2.47.0
    container_name: prometheus-ch
    ports:
      - "9090:9090"
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro

  grafana:
    image: grafana/grafana:10.1.0
    container_name: grafana-ch
    ports:
      - "3000:3000"
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=admin

volumes:
  ch_data:
EOF
Bật native metrics endpoint trên ClickHouse
1. Tạo cấu hình XML cho Prometheus
Không cần cài thêm exporter bên ngoài như clickhouse_exporter của bên thứ ba. ClickHouse đã tích hợp sẵn module OpenMetrics. Bạn chỉ cần thả file cấu hình vào thư mục /etc/clickhouse-server/config.d/:
<clickhouse>
    <prometheus>
        <endpoint>/metrics</endpoint>
        <port>9363</port>
        <metrics>true</metrics>
        <events>true</events>
        <asynchronous_metrics>true</asynchronous_metrics>
        <status_info>true</status_info>
    </prometheus>
</clickhouse>
Bốn cờ này tương ứng với các nhóm bảng nội bộ:
metrics: Trạng thái tức thời từsystem.metrics(số query đang active, background thread đang bận).events: Bộ đếm cộng dồn từsystem.events(tổng số query đã chạy, số bytes đọc/ghi từ disk).asynchronous_metrics: Định kỳ lấy snapshot từsystem.asynchronous_metrics(RAM RSS, số lượng unmerged parts, CPU).status_info: Tình trạng kết nối và sức khỏe tổng thể của node.
2. Cấu hình Scrape Job cho Prometheus
Tạo file prometheus.yml. Ta sẽ cấu hình tần suất lấy mẫu là 10 giây/lần:
global:
  scrape_interval: 10s
  evaluation_interval: 10s

scrape_configs:
  - job_name: 'clickhouse'
    static_configs:
      - targets: ['clickhouse:9363']
        labels:
          cluster: 'analytics-production'
          env: 'prod'
Khởi chạy toàn bộ hệ thống:
docker-compose up -d
Xác thực dữ liệu và thiết lập Dashboard
1. Kiểm tra raw metrics bằng curl
Trước khi tốn thời gian vẽ biểu đồ trên Grafana, bạn cần chắc chắn port 9363 đã nhả dữ liệu:
curl -s http://localhost:9363/metrics | grep -E 'ClickHouseProfileEvents_Query|ClickHouseAsyncMetrics_MemoryTracking'
Đầu ra xuất hiện các dòng text kèm số đo? Tuyệt vời, Prometheus đã có thể phân tích cú pháp dữ liệu này.
2. Những câu PromQL đáng giá nhất cho production
Đăng nhập Grafana tại http://localhost:3000 (tài khoản mặc định: admin/admin). Trỏ Data Source tới http://prometheus:9090, sau đó tập trung thiết lập 3 nhóm cảnh báo cốt lõi:
A. Lưu lượng truy vấn và tải Disk I/O
Nhóm này giúp phát hiện các đợt query spike làm nghẽn CPU hoặc nghẽn ổ đĩa:
# Tần suất query phát sinh mỗi giây (QPS)
rate(ClickHouseProfileEvents_Query[1m])

# Số câu lệnh đang đồng thời chạy trên server
ClickHouseMetrics_Query

# Tốc độ đọc dữ liệu từ ổ cứng (Bps - Bytes per second)
rate(ClickHouseProfileEvents_ReadBufferFromFileDescriptorBytes[1m])
B. Part Mutations và Background Merges
Đây là khu vực nguy hiểm nhất. Nếu hai chỉ số này tăng đột biến, hệ thống đang bị quá tải nợ kỹ thuật:
# Số lượng mutation chưa xử lý xong (nếu chỉ số này tăng liên tục > 20, cần ngừng ALTER ngay)
ClickHouseAsyncMetrics_NumberOfMutations

# Số lượng tác vụ merge và mutation đang chiếm pool xử lý nền
ClickHouseMetrics_BackgroundMergesAndMutationsPoolTask

# Số part lớn nhất trên 1 partition (nguy hiểm khi vượt ngưỡng 150-300 parts)
ClickHouseAsyncMetrics_MaxPartCountForPartition
C. Bộ nhớ RAM và phòng chống OOM Crash
ClickHouse cung cấp cơ chế tracking riêng biệt, nhưng bạn cũng cần đối chiếu với RAM thực tế từ OS:
# RAM do cơ chế nội bộ của ClickHouse tự tính toán
ClickHouseMetrics_MemoryTracking

# RAM thực tế (Resident Set Size - RSS) tiến trình đang chiếm dụng từ hệ điều hành
ClickHouseAsyncMetrics_MemoryResident
Kinh nghiệm thực chiến: Hãy đặt Alert Rule khi ClickHouseAsyncMetrics_MemoryResident chạm 85% dung lượng RAM vật lý của server. Đừng đợi tới 95%, vì một câu truy vấn lớn có thể ngốn sạch 10% còn lại chỉ trong 2-3 giây.
3. Import Dashboard dựng sẵn
Bạn không nhất thiết phải kéo thả từng panel bằng tay. Cộng đồng ClickHouse đã chuẩn bị sẵn các mẫu dashboard trực quan rất chi tiết.
Mở Grafana, chọn Dashboards > Import, nhập ID 14192 (ClickHouse Overview) hoặc 882. Bạn sẽ có ngay biểu đồ phân tích từ Thread Pool, Connection Count, Cache Hit Rate cho tới độ trễ đồng bộ ZooKeeper/Keeper.