深夜2時15分:JWTトークンの大量エラーと時刻ズレの正体
PagerDutyからのアラート通知でスマートフォンが激しく鳴り響きました。マイクロサービス群全体でユーザー認証が突如として一斉に401 Unauthorizedエラーを返却。同時に、PostgreSQLのレプリカノードからもスプリットブレイン検知のアラートが発報されていました。
トランザクションログを確認すると、異常な現象が記録されていました。API Gatewayからリクエストが送信された時刻が02:15:10であるのに対し、バックエンドが受信をログ出力した時刻は02:14:48。なんと時間が22秒も逆行していたのです。
バックエンドノードにSSHログインしてリソース状況を確認したところ、CPU使用率は25%未満、空きメモリは12GB以上と、負荷は極めて正常でした。しかし、時刻確認コマンドを実行した瞬間:
timedatectl status問題の全容が明らかになりました。2台のAPIノード間でシステムクロックが約23秒もズレていたのです。nbf(not before)やexp(expiration time)クレームを含むJWTトークンでは、クロックスキューが5秒を超えただけで認証ライブラリが即座にリクエストを拒否してしまいます。
なぜChronyは突然同期を停止したのか?
現代のLinuxディストリビューション(Ubuntu 20.04/22.04/24.04、RHEL 8/9、Rocky Linuxなど)では、ntpdに代わりChronyが標準採用されています。Chronyは迅速に時刻を収束させ、クロックドリフトを滑らかに補正する優れたデーモンです。しかし、多くの現場では一度セットアップしたきり放置され、稼働状態の監視設定が見落とされがちです。
障害が発生したノードでChronyのトラッキング状況を詳細に確認します:
chronyc tracking返ってきた出力は、完全に同期が失われている状態を示していました:
Reference ID    : 00000000 ()  # アップストリームサーバーなし
Stratum         : 0
Ref time (UTC)  : Thu Jan 01 00:00:00 1970
System time     : 22.841920853 seconds slow of NTP time  # 22.8秒遅延
Last offset     : +0.000000000 seconds
RMS offset      : 0.000000000 seconds
Frequency       : 12.450 ppm slow
Residual freq   : +0.000 ppm
Skew            : 0.000 ppm
Root delay      : 1.000000000 seconds
Root dispersion : 1.000000000 seconds
Update interval : 0.0 seconds
Leap status     : Not synchronised
このような同期停止を引き起こす代表的な3大原因は以下の通りです:
- UDP 123番ポートの遮断: ネットワークチームによるファイアウォール強化やSecurity Groupの変更により、意図せずアウトバウンドのUDP 123がブロックされるケース。Chronyが
pool.ntp.orgなどのNTPプールへ通信できなくなります。 - プロセスクラッシュ後の未再起動:
chronydプロセスがOOM Killerによって強制終了されたり、予期せぬクラッシュを起こしたケース。デフォルトのsystemdサービス定義に自動再起動ディレクティブが不足していると停止したままになります。 - 仮想マシン特有のクロックドリフト: 仮想化基盤(KVM、VMware、AWS EC2など)では、CPUサイクルの競合により仮想クロックが急速にドリフトします。NTPによる継続的な補正がないと、1日で数秒単位のズレが生じることも珍しくありません。
障害対応:対症療法か、恒久対策か?
方法1:makestepコマンドによる緊急復旧
サービスを即座に復旧させる必要がある場合、Chronyに徐々に時刻を合わせる(slew)のではなく、強制的に時刻をジャンプ(step time)させることができます:
# サービスを再起動し、ステップ同期を強制実行
sudo systemctl restart chrony || sudo systemctl restart chronyd
sudo chronyc makestep
このコマンドによってオフセットは数ミリ秒以内に収まります。しかし、UDP 123番ポートが塞がれたままであったり、数日後にデーモンが再クラッシュした場合、障害は確実に再発します。
方法2:CrontabでBashスクリプトを定期実行
一部のエンジニアは、5分ごとにcronjobでオフセットを取得し、SlackやTelegramのWebhookへアラートを投げる簡易スクリプトを作成します:
#!/bin/bash
OFFSET=$(chronyc tracking | grep 'System time' | awk '{print $4}')
# OFFSETが閾値0.5秒を超えた場合にアラートを送信
このアプローチは一時しのぎにはなりますが、すぐに限界を迎えます。Cronjobでは時刻ドリフトの推移グラフを描画できず、スクリプト自体の異常終了を検知する仕組みもありません。さらに数百台規模のサーバー群への一元管理は困難です。
本番環境の標準解:Prometheus Chrony Exporterによる監視
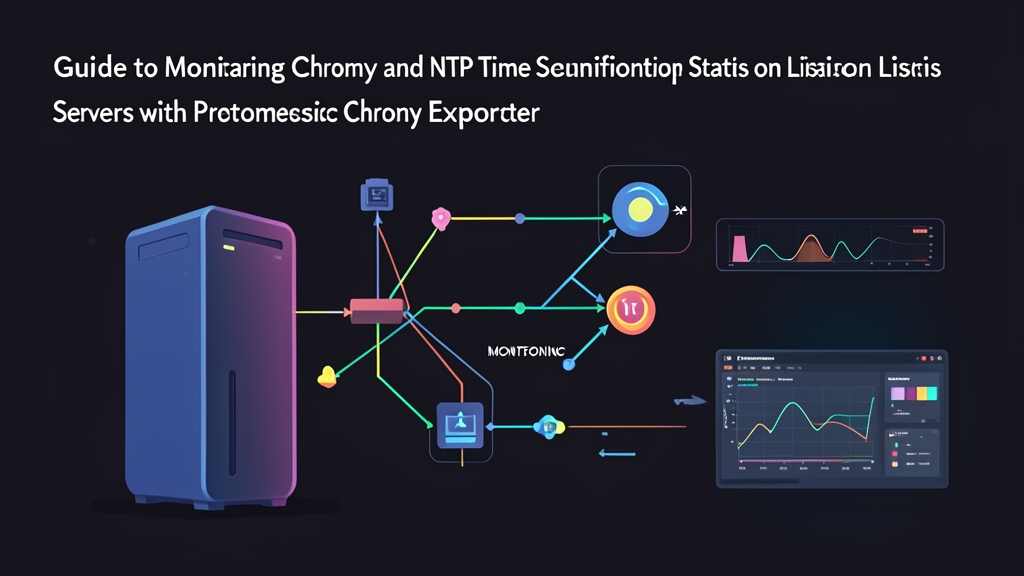
障害発生を待つ受け身の運用から脱却し、クロックオフセット、Stratum、同期状態などのメトリクスをPrometheusへ集約して一元監視すべきです。ここではSuperQ氏によって開発・公開されているオープンソースのchrony_exporterを活用します。
ステップ1:LinuxサーバーへのChrony Exporterインストール
公式GitHubリリースからコンパイル済みバイナリをダウンロードします:
ARCH="amd64"
VERSION="0.10.0"
curl -sLO "https://github.com/superq/chrony_exporter/releases/download/v${VERSION}/chrony_exporter-${VERSION}.linux-${ARCH}.tar.gz"

tar -xvf "chrony_exporter-${VERSION}.linux-${ARCH}.tar.gz"
sudo mv "chrony_exporter-${VERSION}.linux-${ARCH}/chrony_exporter" /usr/local/bin/
sudo chmod +x /usr/local/bin/chrony_exporter
rm -rf "chrony_exporter-${VERSION}"*
ステップ2:Systemdサービスの設定
セキュリティを担保するため、ログインシェルを持たない専用のシステムユーザーを作成し、その権限でExporterを実行します:
sudo useradd -r -s /bin/false prometheus_exporter 2>/dev/null || true

sudo tee /etc/systemd/system/chrony_exporter.service << 'EOF'
[Unit]
Description=Prometheus Chrony Exporter
After=network.target chrony.service chronyd.service
Wants=chrony.service chronyd.service

[Service]
Type=simple
User=prometheus_exporter
Group=prometheus_exporter
ExecStart=/usr/local/bin/chrony_exporter --chrony.address=127.0.0.1:323
Restart=always
RestartSec=5s

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now chrony_exporterChronyはデフォルトでローカルループバックのUDPポート127.0.0.1:323に管理用ソケットを開きます。/etc/chrony/chrony.conf(CentOS/RHELの場合は/etc/chrony.conf)を確認し、cmdallow 127.0.0.1またはbindcmdaddress 127.0.0.1が有効になっていることを確かめてください。
ローカルでメトリクスエンドポイントの出力を確認します:
curl -s http://localhost:9148/metrics | grep -E '^chrony_(last_offset|leap_status|stratum)'正常に動作していれば、以下のようなPrometheus形式のメトリクスが返されます:
# HELP chrony_last_offset_seconds Last clock offset
# TYPE chrony_last_offset_seconds gauge
chrony_last_offset_seconds 0.000048120
# HELP chrony_leap_status Leap status (0: Normal, 1: 61s, 2: 59s, 3: Not synchronized)
# TYPE chrony_leap_status gauge
chrony_leap_status 0
# HELP chrony_stratum Chrony stratum
# TYPE chrony_stratum gauge
chrony_stratum 2
ステップ3:Prometheusスクレイプジョブの定義
prometheus.ymlにメトリクス収集ジョブを追加します:
scrape_configs:
  - job_name: 'chrony_monitoring'
    scrape_interval: 15s
    static_configs:
      - targets:
          - '10.0.1.15:9148'
          - '10.0.1.16:9148'
          - '10.0.1.17:9148'
        labels:
          tier: 'backend'
          env: 'production'
リロードAPIを呼び出して設定変更を反映します:
curl -X POST http://localhost:9090/-/reloadステップ4:早期検知アラートルールの設定
オフセットが5秒を超えるまで待っていてはいけません。ルールファイル(例:alerts/chrony_rules.yml)を作成し、早期警告用の閾値を定義します:
groups:
  - name: chrony_alerts
    rules:
      # オフセットが100msを3分間超え続けた場合の警告
      - alert: ChronyClockOffsetWarning
        expr: abs(chrony_last_offset_seconds) > 0.1
        for: 3m
        labels:
          severity: warning
        annotations:
          summary: "サーバー {{ $labels.instance }} で時刻ズレの兆候"
          description: "クロックオフセットが {{ $value | printf '%.4f' }}秒となり、許容閾値100msを超過しています。"

      # オフセットが500msを超えた場合の緊急アラート
      - alert: ChronyClockOffsetCritical
        expr: abs(chrony_last_offset_seconds) > 0.5
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "{{ $labels.instance }} で深刻な時刻ズレが発生"
          description: "クロックオフセットが {{ $value | printf '%.4f' }}秒に達しました。JWT認証失敗やDBスプリットブレインの危険があります。"

      # アップストリームNTPサーバーとの通信が完全に途絶した場合のアラート
      - alert: ChronyNotSynchronised
        expr: chrony_leap_status == 3
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "{{ $labels.instance }} のChrony同期が完全に停止"
          description: "過去5分間にわたり、いずれのアップストリームNTPサーバーとも同期できていません。"

      # Exporterサービスがダウンした場合のアラート
      - alert: ChronyExporterDown
        expr: up{job="chrony_monitoring"} == 0
        for: 3m
        labels:
          severity: warning
        annotations:
          summary: "{{ $labels.instance }} のChrony Exporterが応答停止"
おわりに
時刻同期はインフラにおいて最も軽視されやすい要素の一つですが、一度破綻するとシステム全体を麻痺させる破壊力を持っています。chrony_last_offset_secondsとchrony_leap_statusという2つの重要指標を定常監視することで、わずか数十ミリ秒の微小なドリフトも見逃さず、深夜の突発的な障害コールに怯える日々を完全に終わらせることができます。