1. 午後2時に起きたDROP TABLEの悪夢
金曜日の午後14時15分。コーヒーを淹れて一息つこうとしたその瞬間、Slackのアラートチャンネルが一斉に鳴り響きました。ステージング環境のDBを整理するはずだったジュニアエンジニアが、誤って本番環境のターミナルに接続していたのです。コマンドはわずか0.2秒で完了してしまいました。
DROP TABLE orders; -- 14:15:23に実行120万件以上のレコードを抱えるordersテーブルが一瞬で消失。決済ゲートウェイでエラーが多発し、顧客はチェックアウトできなくなりました。
システムの直近のフルバックアップ(Full Backup)は当日の午前0時00分に完了したものです。もしそのバックアップファイルをそのままリストアすれば、過去14時間以上の取引データがすべて消滅してしまいます。深夜から午後にかけて発生した約8,500件の注文データが完全に消失することになり、ビジネス部門や経理部門が納得するはずもありません。
通常のロールバックは不可能です。誤操作への防壁としてあらかじめDelayed Replication(遅延レプリケーション)を導入していなければ、この時点で残された唯一の目標は、DROP文がコミットされる直前の1秒前、すなわち14:15:22の時点にデータベースを巻き戻すことです。
2. なぜフルバックアップだけではリスクが高いのか?
毎晩cronでmysqldumpを実行するジョブを設定しただけで安心してしまうチームは少なくありません。しかし、この運用には致命的な落とし穴があります。
- フルバックアップは、特定の時点 $T_0$(00:00)におけるデータベースの状態をスナップショットとして記録しているにすぎません。
- $T_0$ から障害発生時点 $T_1$(14:15)までの間に発生したすべてのINSERT、UPDATE、DELETE文は、そのバックアップ
.sqlファイルには含まれていません。
では、その14時間のデータはどこへ消えてしまったのでしょうか? サーバーでバイナリログ(Binary Log / binlog)が有効になっていれば、MySQLはスキーマ変更やデータ変更のすべてをバイナリログファイルに記録しています。正常にコミットされた各トランザクションには、正確なタイムスタンプとバイト位置(Position)が付与されています。
小さなインシデントが大惨事へと発展してしまう主な原因は、次の2点に集約されます。
- サーバーでbinlogが有効化されていないか、ログの自動削除期間(expire logs)が24時間未満と短すぎる設定になっていること。
- 運用チームがPoint-in-Time Recovery(PITR)の手順を一度も訓練(リカバリ訓練)したことがなく、いざ障害が起きた際に混乱してデータを誤って上書きしてしまうこと。
3. 障害対応における3つのアプローチの比較
重要なテーブルがDROPされてしまった場合、検討できる選択肢は主に3つあります。
アプローチ1:直近のフルバックアップをそのままリストアする
最もシンプルな方法です。午前0:00のダンプファイルを再インポートし、そのままアプリケーションの稼働を再開させます。
- メリット: 手順が単純で迅速。
mysql < backup.sqlという単一のコマンドを実行するだけで、20〜30分程度で完了します。 - デメリット: 直近14時間のデータが完全に失われます。開発/ステージング環境や、更新頻度の極めて低い社内システムでのみ許容される手段です。
アプローチ2:アクセスログを解析して手動でデータを再構築する
00:00時点のバックアップをリストアした後、バックエンドチームがNginxやマイクロサービスのログを解析してペイロードを抽出し、スクリプトを実行して注文データを補填します。
- メリット: ログに残っている注文データの一部を回収できる可能性があります。
- デメリット: 膨大な工数と日数がかかります。サードパーティのWebhook、適用された割引クーポン、レースコンディションなどを完全に再現することが難しく、データの整合性が崩れやすくなります。
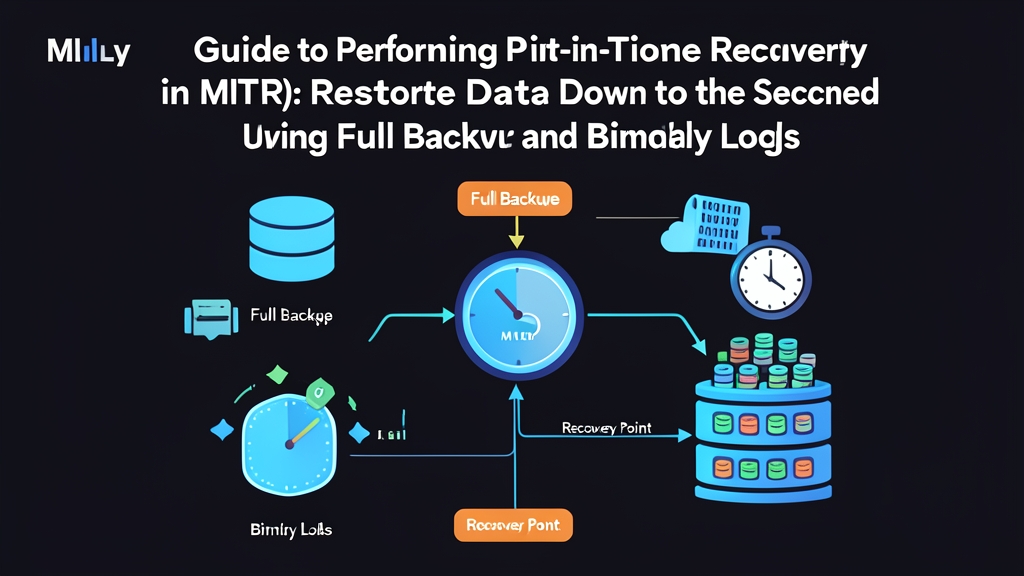
アプローチ3:フルバックアップ+バイナリログによるPoint-in-Time Recovery(PITR)
新規インスタンス上に00:00のフルバックアップをリストアします。その上で、mysqlbinlogツールを使用して00:00:01から14:15:22までのトランザクションをすべてリプレイ(再実行)し、テーブルDROP文の直前で意図的に停止させます。
- メリット: 障害発生直前のミリ秒単位に至るまで、正常なデータを100%完全に保持・復元できます。
- デメリット: binlogのPosition(位置情報)を正確に把握するスキルが必要であり、ログファイルの適用漏れを防ぐための慎重なオペレーションが求められます。
4. 本番環境向けPITR実践手順(6ステップ)
以下の手順は、Linux環境で稼働しているMySQL 8.0 / 5.7にそのまま適用できます。
ステップ1:バイナリログの設定確認
設定ファイル/etc/mysql/mysql.conf.d/mysqld.cnf(またはmy.cnf)を確認します。サーバーに以下の設定が記述されている必要があります。
[mysqld]
server-id = 1
log_bin = /var/log/mysql/mysql-bin.log
binlog_format = ROW
binlog_expire_logs_seconds = 604800 # ログを7日間保持(MySQL 8.0)
MySQLターミナルで以下のコマンドを実行し、設定状況を素早く確認します。
SHOW VARIABLES LIKE 'log_bin';
-- 'ON'が返れば要件を満たしています
ステップ2:binlog位置情報を記録したフルバックアップの作成
日次の定期バックアップをmysqldumpで実行する際は、必ず--source-data=2(MySQL 8.0.26以降)または--master-data=2(それ以前のバージョン)フラグを使用してください。このフラグを--single-transactionと併用することで、テーブルを長時間ロックすることなく、ダンプ時点の正確なbinlog位置をスナップショットとして記録できます。
mysqldump -u root -p --single-transaction --source-data=2 --databases production_db > full_backup_00h.sqlダンプファイルの先頭25行を確認し、復元開始位置となるbinlog座標を取得します。
head -n 25 full_backup_00h.sql | grep "CHANGE REPLICATION"出力例:
-- CHANGE REPLICATION SOURCE TO SOURCE_LOG_FILE='mysql-bin.000005', SOURCE_LOG_POS=157;この行は、mysql-bin.000005ファイルのバイト位置157までの全データが、すでにこのダンプファイルに含まれていることを示しています。
ステップ3:データベースの隔離とbinlogファイルの切り替え
障害の発生しているデータベースに新規の書き込みトラフィックが入り続けないようにします。直ちにデータベースを読み取り専用(Read-Only)に切り替えるか、ProxySQLなどのゲートウェイでメンテナンス画面を表示させてください。
SET GLOBAL read_only = ON;続いて、以下のログローテーションコマンドを実行します。
FLUSH LOGS;これによりMySQLはmysql-bin.000005ファイルをクローズし、新しいmysql-bin.000006ファイルを開きます。事故が発生したログファイルのサイズが確定し、新規データによってログが汚染されるのを防ぐことができます。
ステップ4:DROP TABLE文の位置(Position)を特定する
mysqlbinlogツールを使ってログファイルの内容を読み込み、DROP文を検索・特定します。
mysqlbinlog -v /var/log/mysql/mysql-bin.000005 | grep -B 3 -A 3 -i "DROP TABLE"ターミナルに出力される結果例:
# at 742180
#241104 14:15:23 server id 1  end_log_pos 742265 CRC32 0x9f5a7d21   Query   thread_id=45    exec_time=0 error_code=0
SET TIMESTAMP=1730729723/*!*/;
DROP TABLE `orders` /* xid=1284 */
/*!*/;
この出力から、次の2つの重要なポイントが判明します。
DROP TABLEコマンドの開始位置(Position):742180- 安全に復元可能な最後の位置:742180の直前
ここでのタスクは、Position 157からPosition 742180の手前までの全イベントをリプレイすることです。
ステップ5:正常なトランザクションをSQLファイルに抽出する
--start-positionと--stop-positionパラメータを使用して、binlogファイルから正常なトランザクションのみを一時SQLファイルへ抽出します。
mysqlbinlog --start-position=157 --stop-position=742180 \
  --database=production_db \
  /var/log/mysql/mysql-bin.000005 > /tmp/replay_transactions.sql
このコマンドにより、位置742180にあるDROP TABLE文が完全に除外されます。生成された/tmp/replay_transactions.sqlには、00:00:01から14:15:22までに発生した注文やカート更新などの正常なトランザクションのみが含まれます。
ステップ6:待機系サーバーまたは一時データベースへのリストア
障害が発生している本番インスタンスへ直接リストアすることは絶対に避けてください。検証用のステージングサーバーを用意するか、一時的なスキーマproduction_recoveryを作成して作業を行います。
1. 00:00時点のフルバックアップをインポートします:
mysql -u root -p production_recovery < full_backup_00h.sql2. binlogから抽出した差分トランザクションを適用します:
mysql -u root -p production_recovery < /tmp/replay_transactions.sql3. レコード数と最新日時を突合・検証します:
SELECT COUNT(*) AS total_orders FROM production_recovery.orders;
SELECT MAX(created_at) AS latest_order FROM production_recovery.orders;結果として2024-11-04 14:15:21の日時が確認できれば成功です。午前中に発生した約8,500件の注文データが1件の欠損もなく完全に復旧しました。
5. PITR運用における3つの重要ポイント
- DatetimeではなくPositionを使用する:
--stop-datetimeパラメータは、サーバー(UTC)と作業端末のタイムゾーンの差異によってズレが生じやすくなります。完全な精度を担保するためには、必ず--stop-positionを使用してください。 - インポート時はbinlogの出力を無効化する: リカバリ先サーバーへ大量のデータをインポートする際は、そのセッション内で
SET sql_log_bin = 0;を実行してください。ディスクI/Oを大幅に削減でき、リストア速度が2〜3倍向上します。 - binlogを外部ストレージへ退避する: データベースサーバーのSSDが物理的にクラッシュした場合、ローカルにのみ保存されたbinlogは道連れになって消失します。rsyncスクリプトやPercona XtraBackupなどのツールを活用し、15〜30分おきにbinlogをS3やMinIOなどの外部ストレージへ転送する仕組みを構築しておきましょう。