従来のReplication構成では不十分な理由
従来のMySQLマスター・スレーブ構成の運用には、常に「深夜に突然マスターが停止する」という不安が付きまといます。障害発生時に手動で対応する場合、以下のような難題に直面します。
- どのレプリカが最新のバイナリログを保持しているか?
- レプリカをマスターへ昇格させる際、処理中トランザクション(in-flight transaction)の消失は発生しないか?
- スプリットブレインが発生し、2台のノードが同時に書き込みを受け付けた場合のデータ不整合をどう解消するか?
実環境において、データ消失リスクはシステム規模に比例して増大します。例えば2,000 write OPSを処理する決済システムでは、わずか数秒のレプリケーション遅延であってもRPO(目標復旧時点)の観点から数千件ものレコード欠損につながります。手動フェイルオーバーには通常10〜30分のダウンタイムを要し、これは一般的なSLAの基準値を大幅に超過してしまいます。
モダンなシステムには、自動合意形成(consensus)を行い、障害ノードを自動切り離ししてリアルタイムに新リーダーを選出する仕組みが不可欠です。Oracle社がまさにこの課題を解決するために設計したのが「MySQL Group Replication(MGR)」です。
PaxosとGroup Replicationの動作メカニズム
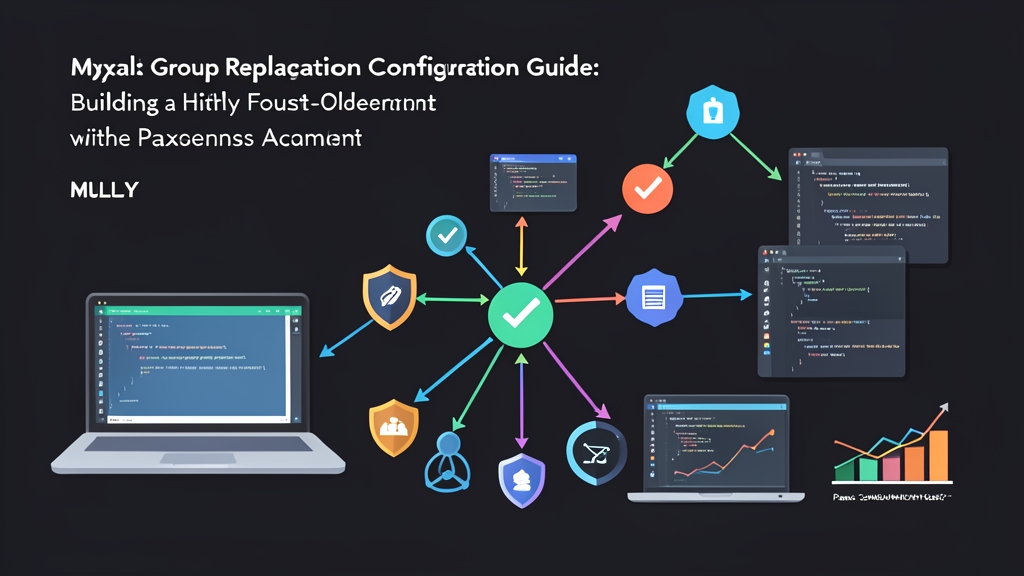
受動的な一方通行の非同期レプリケーションとは異なり、MGRはグループ通信システム層であるXCom(Group Communication System)を統合し、Paxos合意アルゴリズムの変種に基づいて動作します。
1. Paxosを介したトランザクション処理フロー
あるノードでトランザクションがコミットされようとする際、即座にディスクへの書き込みが行われるわけではありません。代わりに、write-setデータ(主キーのハッシュ値とスナップショットバージョンを含む)がXComポート(デフォルト: 33061)経由でクラスタ内の全メンバーへブロードキャストされます。
クラスタは過半数(Quorum)の合意メカニズムに従って判定を行います:
- 50%超のノードが承認し、グローバルな実行順序(global order)に合意した時点で、トランザクションは有効とみなされます。
- Certification(認証)フェーズでバージョンの競合が検証されます。先行して同一行を上書きしたトランザクションが存在しなければ、元ノードでのコミットが完了し、残りのノードにも変更が適用されます。
- クラスタが
F台のノードの同時障害に耐えるには、最低2F + 1台のノードが必要です。3ノード構成(N=3)であれば、1台に障害が発生してもクラスタは安定して稼働を継続できます。
2. Single-Primary vs Multi-Primary Mode
MGRは2つの運用モードをサポートしています:
- Single-Primary Mode(推奨): クラスタ内で1台のノードのみがRead/Writeを受け付け、その他のノードは読み取り専用(Secondary)として動作します。Primaryノードがダウンした場合、Paxosが2〜5秒以内に最も優先度の高いSecondaryノードを新Primaryへ自動昇格させます。アプリケーション側で複雑なロジックを組む必要はほぼありません。
- Multi-Primary Mode: すべてのノードが同時に書き込みを受け付ける構成です。2台のノードが同一行を同時に更新した場合、Certificationメカニズムによって後から到着したトランザクションが自動的に拒否・ロールバックされます。適用できるユースケースが限定され、アプリケーション側で厳密なリトライ処理を実装する必要があります。
3ノード構成によるMySQL Group Replicationの構築
Ubuntu 22.04 LTSおよびMySQL 8.0を使用し、Single-Primary構成の3ノードクラスタを構築します:
- Node 1:
192.168.10.11(ホスト名:mgr-node1) - Node 2:
192.168.10.12(ホスト名:mgr-node2) - Node 3:
192.168.10.13(ホスト名:mgr-node3)
ステップ1: 前提条件の設定
MGRでは、ストレージエンジンにInnoDBを使用すること、GTID(Global Transaction Identifier)の有効化、バイナリログ形式のROW設定、全テーブルへのPrimary Keyの定義が必須要件となります。
Node 1の /etc/mysql/mysql.conf.d/mysqld.cnf を開き、以下の設定を追加します:
[mysqld]
server_id = 1
gtid_mode = ON
enforce_gtid_consistency = ON
binlog_format = ROW
log_replica_updates = ON
binlog_checksum = NONE

# Group Replication プラグインの起動設定
plugin_load_add = 'group_replication.so'
group_replication_group_name = "8a9f24e0-7bf2-11ed-a1eb-0242ac120002"
group_replication_start_on_boot = OFF
group_replication_local_address = "192.168.10.11:33061"
group_replication_group_seeds = "192.168.10.11:33061,192.168.10.12:33061,192.168.10.13:33061"
group_replication_bootstrap_group = OFF
group_replication_single_primary_mode = ON
group_replication_enforce_update_everywhere_checks = OFF
Node 2およびNode 3でも同様の設定を行いますが、server_idをそれぞれ2および3に変更し、group_replication_local_addressパラメータには各ノード自身のIPアドレスを指定してください。
ステップ2: レプリケーション専用ユーザーの作成
データ復旧チャネルに権限を付与するため、3台すべてのノードでMySQLにログインして以下を実行します:
SET SQL_LOG_BIN=0;
CREATE USER 'repl'@'%' IDENTIFIED BY 'MatKhauBaoMatCucCao123@';
GRANT REPLICATION SLAVE ON *.* TO 'repl'@'%';
GRANT BACKUP_ADMIN ON *.* TO 'repl'@'%';
FLUSH PRIVILEGES;
SET SQL_LOG_BIN=1;

CHANGE REPLICATION SOURCE TO SOURCE_USER='repl', SOURCE_PASSWORD='MatKhauBaoMatCucCao123@' FOR CHANNEL 'group_replication_recovery';
ステップ3: グループの初期化(Node 1でのブートストラップ)
クラスタを立ち上げるためのブートストラップフラグを有効化できるのは、最初の1台のみです。Node 1で以下を実行します:
SET GLOBAL group_replication_bootstrap_group=ON;
START GROUP_REPLICATION;
SET GLOBAL group_replication_bootstrap_group=OFF;完了後は直ちにbootstrap_groupフラグをOFFに戻してください。これにより、次回サービス再起動時にノードが誤って新しいグループを生成してしまうのを防ぎます。
ステップ4: Node 2およびNode 3のクラスタ参加
Node 2およびNode 3では、ブートストラップフラグを使用せず直接参加コマンドを実行します:
START GROUP_REPLICATION;システムはrecovery channelを経由して、Node 1の既存スキーマおよびデータを新しいノードへ自動的に同期します。
ステップ5: 稼働ステータスの確認
いずれかのノードでPerformance Schemaテーブルを照会します:
SELECT member_id, member_host, member_port, member_state, member_role
FROM performance_schema.replication_group_members;全ノードのステータスがONLINEと表示されていれば、クラスタの準備は完了です:
+--------------------------------------+---------------+-------------+--------------+-------------+
| MEMBER_ID                            | MEMBER_HOST   | MEMBER_PORT | MEMBER_STATE | MEMBER_ROLE |
+--------------------------------------+---------------+-------------+--------------+-------------+
| 306c58cf-5e8c-11ed-9f86-000c29a8a111 | 192.168.10.11 |        3306 | ONLINE       | PRIMARY     |
| 422d8612-5e8c-11ed-8f52-000c29a8a222 | 192.168.10.12 |        3306 | ONLINE       | SECONDARY   |
| 505d9123-5e8c-11ed-7a11-000c29a8a333 | 192.168.10.13 |        3306 | ONLINE       | SECONDARY   |
+--------------------------------------+---------------+-------------+--------------+-------------+
ステップ6: 擬似障害によるフェイルオーバーテスト
Node 1のMySQLプロセスを停止し、クラスタの挙動を検証します:
sudo systemctl stop mysqlNode 2からクラスタの状態を再確認します。3〜5秒以内にNode 1がUNREACHABLEステータスへ遷移し、その後自動的にメンバー一覧から除外されます。
続いてNode 2またはNode 3が新しいPRIMARYに昇格します。コミット済みトランザクションはすべて完全に維持されます(RPO = 0)。
まとめと本番環境運用の推奨事項
MySQL Group Replicationは標準的な分散データベースアーキテクチャを提供し、サードパーティ製ツールを介在させることなくスプリットブレインを防ぎます。本番環境で安全に運用するためのポイントは以下の通りです:
- Quorumの成立条件を満たすため、ノード数は常に奇数(最低3ノード)を維持すること。
- フェイルオーバー後に読み書きクエリを新しいPrimaryへ自動ルーティングできるよう、ProxySQLやMySQL Routerを中間に配置すること。
- Paxos合意形成のオーバーヘッドを抑えるため、ノード間のネットワークレイテンシを10ms未満に抑えること。