Sự cố 504 Gateway Timeout lúc nửa đêm: Khi RAG truyền thống đuối sức
Đúng 2h15 sáng, PagerDuty réo liên hồi vì cụm worker báo lỗi 504 Gateway Timeout hàng loạt. Mở log ra trace, thủ phạm quen thuộc lại xuất hiện: marketing ném vào một prompt quá rộng, đòi tổng hợp số liệu của 20 đối thủ. Pipeline RAG đơn tuyến lúc đó cố nhồi cả tá trang web thô vào một LLM call. Hậu quả là context vượt quá 128k token, chưa kể các thread cào web song song bị timeout sạch.
Thực tế production chứng minh: RAG cơ bản hay zero-shot LLM không gánh nổi bài toán nghiên cứu sâu (Deep Research). Gặp câu hỏi phức tạp, pipeline thông thường chỉ query vector search 1-2 lần rồi trả lời ngay. Mô hình thiếu dữ liệu bèn tự bịa (hallucinate), hoặc cho ra báo cáo hời hợt, không dùng được.
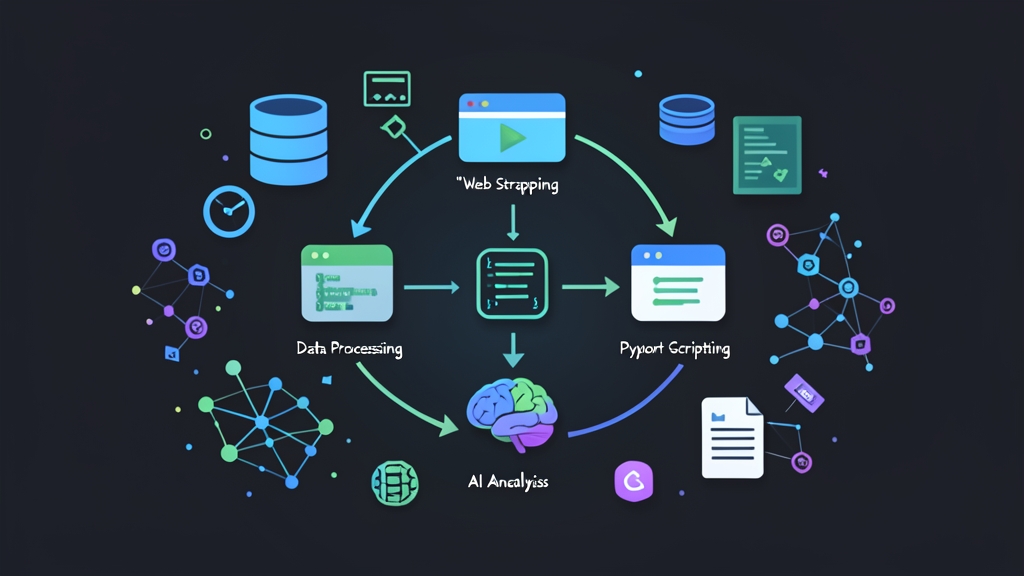
Mô hình Open Deep Research giải quyết triệt để bài toán này. Thay vì ép LLM trả lời ngay lập tức, hệ thống tách quy trình thành một vòng lặp tự trị (autonomous loop):
- Lập kế hoạch (Planning): Tách câu hỏi lớn thành các bài toán con (ví dụ: chia chủ đề “so sánh chip AI” thành kiến trúc, giá bán, năng lực inference).
- Tìm kiếm đệ quy (Recursive Search): Truy vấn web qua search engine, đọc lướt nội dung, rồi tự sinh query đào sâu nếu phát hiện số liệu bị khuyết.
- Tổng hợp & Kiểm chứng (Synthesis & Fact-checking): Đối chiếu chéo các nguồn, lọc bỏ nội dung rác và xuất báo cáo chuẩn Markdown kèm URL nguồn.
Tự dựng pipeline bằng Python giúp bạn kiểm soát hoàn toàn flow thực thi. Bạn dễ dàng đặt hard-limit cho token, chặn rò rỉ bộ nhớ và không phụ thuộc vào các API đóng đắt đỏ.
Chuẩn bị môi trường chạy
Trên server Ubuntu 22.04 / 24.04, bạn nên cô lập dependencies trong virtual environment riêng để tránh xung đột gói hệ thống.
1. Thiết lập Virtual Environment
# Tạo thư mục làm việc và kích hoạt môi trường ảo Python 3.11+
mkdir -p /opt/open-deep-research && cd /opt/open-deep-research
python3 -m venv venv
source venv/bin/activate

# Nâng cấp công cụ build cơ bản
pip install --upgrade pip setuptools wheel
2. Cài đặt các thư viện cần thiết
Chúng ta chọn duckduckgo-search để query web không tốn phí API key, trafilatura để lọc text sạch (loại bỏ thẻ script, quảng cáo, nav bar), cùng SDK openai tương thích tốt với OpenAI, OpenRouter hoặc vLLM/Ollama self-hosted.
pip install openai duckduckgo-search trafilatura pydantic tenacity richXây dựng Deep Research Agent: Chi tiết từng module
Để tránh lỗi loop vô tận làm ngốn quota, mã nguồn được chia thành 3 phần rõ ràng: module cào web an toàn, agent điều phối vòng lặp và script chạy thử nghiệm.
1. Module tìm kiếm & bóc tách text an toàn
File tools.py xử lý việc search và crawl text. Mã nguồn tích hợp retry với exponential backoff để vượt qua các đợt gián đoạn mạng hoặc rate limit.
import trafilatura
from duckduckgo_search import DDGS
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=2, max=6))
def search_web(query: str, max_results: int = 3) -> list[dict]:
    """Tìm kiếm web qua DuckDuckGo kèm cơ chế retry khi dính rate limit."""
    results = []
    with DDGS() as ddgs:
        raw_results = ddgs.text(query, max_results=max_results)
        if raw_results:
            for item in raw_results:
                results.append({
                    "title": item.get("title", ""),
                    "url": item.get("href", ""),
                    "snippet": item.get("body", "")
                })
    return results

def fetch_clean_content(url: str, max_chars: int = 4000) -> str:
    """Tải trang web và bóc tách text chính, cắt ngắn ký tự để tránh tràn context."""
    try:
        downloaded = trafilatura.fetch_url(url, timeout=10)
        if not downloaded:
            return ""
        text = trafilatura.extract(downloaded, include_links=False, include_comments=False)
        return text[:max_chars] if text else ""
    except Exception as err:
        return f"Lỗi đọc {url}: {err}"
2. Module Agent điều phối vòng lặp đệ quy
File agent.py đóng vai trò nhạc trưởng. Sau mỗi lượt đọc tài liệu, mô hình tự đánh giá: “Dữ liệu hiện tại đã đủ số liệu và luận điểm chưa? Nếu chưa, cần search thêm keyword nào?”
import os
import json
from openai import OpenAI
from tools import search_web, fetch_clean_content

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY", "sk-mock-key"))

class DeepResearchAgent:
    def __init__(self, max_iterations: int = 3):
        self.max_iterations = max_iterations
        self.collected_evidence = []

    def plan_next_step(self, topic: str, history: str) -> dict:
        """Đánh giá dữ liệu hiện có và quyết định query tiếp theo."""
        prompt = f"""Bạn là AI nghiên cứu chuyên sâu. Mục tiêu: Nghiên cứu chủ đề: "{topic}"
Các thông tin đã thu thập được:
{history}

Hãy phân tích và trả về đúng JSON theo mẫu:
{{
  "is_sufficient": true/false,
  "reason": "Giải thích ngắn gọn tại sao đã đủ hoặc còn thiếu số liệu gì",
  "next_query": "Từ khóa tìm kiếm tiếp theo nếu thiếu (để trống nếu đã đủ)"
}}"""
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": prompt}],
            temperature=0.2
        )
        return json.loads(response.choices[0].message.content)

    def run(self, topic: str) -> str:
        print(f"[*] Bắt đầu nghiên cứu: {topic}")
        current_query = topic

        for iteration in range(1, self.max_iterations + 1):
            print(f"\n--- Vòng lặp {iteration}/{self.max_iterations}: Tìm kiếm '{current_query}' ---")
            search_hits = search_web(current_query, max_results=2)

            for hit in search_hits:
                url = hit["url"]
                print(f" -> Đang crawl: {url}")
                page_text = fetch_clean_content(url)
                if page_text:
                    self.collected_evidence.append({
                        "source": url,
                        "query": current_query,
                        "snippet": page_text
                    })

            # Đưa tóm tắt bằng chứng gần nhất cho Agent xem xét
            evidence_summary = "\n".join([
                f"- Nguồn [{e['source']}]: {e['snippet'][:250]}..."
                for e in self.collected_evidence[-4:]
            ])

            decision = self.plan_next_step(topic, evidence_summary)
            if decision.get("is_sufficient") or iteration == self.max_iterations:
                print(f"[*] Đã đạt điều kiện dừng: {decision.get('reason')}")
                break

            current_query = decision.get("next_query", topic)

        return self.generate_report(topic)

    def generate_report(self, topic: str) -> str:
        """Tổng hợp toàn bộ bằng chứng thu thập được thành báo cáo kỹ thuật."""
        print("\n[*] Đang tổng hợp báo cáo hoàn chỉnh...")
        raw_data = "\n\n".join([
            f"### Nguồn: {e['source']}\n{e['snippet']}"
            for e in self.collected_evidence
        ])

        system_prompt = "Bạn là chuyên gia phân tích kỹ thuật. Viết báo cáo tổng hợp chi tiết bằng Markdown dựa hoàn toàn trên các trích dẫn được cung cấp. Bắt buộc phải gắn kèm URL nguồn tương ứng cho mỗi luận điểm."
        user_prompt = f"Chủ đề: {topic}\n\nDữ liệu nghiên cứu:\n{raw_data}"

        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt}
            ],
            temperature=0.3
        )
        return response.choices[0].message.content
3. Script khởi chạy kiểm thử
File main.py nhận chủ đề đầu vào, kích hoạt worker và lưu kết quả ra file Markdown:
import os
from agent import DeepResearchAgent

def main():
    if not os.getenv("OPENAI_API_KEY"):
        raise ValueError("Thiếu biến môi trường OPENAI_API_KEY!")

    topic = "Kiến trúc bộ nhớ ngoài cho AI Agent: Đánh giá MemGPT so với Vector DB truyền thống về latency và chi phí token"
    agent = DeepResearchAgent(max_iterations=3)
    report = agent.run(topic)

    output_file = "deep_research_report.md"
    with open(output_file, "w", encoding="utf-8") as f:
        f.write(report)

    print(f"\n[✓] Xong! Báo cáo đã lưu tại: {output_file}")

if __name__ == "__main__":
    main()
Vận hành Production: Giữ ngân sách và tài nguyên server trong tầm kiểm soát
Code chạy nuột trên localhost không đồng nghĩa với việc sống sót trên production. Khi giao worker xử lý hàng trăm task mỗi ngày, bạn cần thiết lập 3 chốt chặn kỹ thuật sau:
1. Test luồng thực thi thực tế
Chạy script và theo dõi log chi tiết trong terminal:
export OPENAI_API_KEY="sk-your-actual-api-key"
python3 main.py
Terminal sẽ thể hiện rõ tư duy của Agent qua từng bước. Ví dụ: ở vòng 1, Agent đọc được định nghĩa MemGPT; đến vòng 2, nó nhận ra thiếu bảng benchmark latency nên chủ động sinh query MemGPT vs Pinecone latency benchmark để tìm tiếp trước khi xuất file deep_research_report.md.
2. Ba điểm gãy (Failure Points) và cách phòng chống
- Khống chế số vòng lặp (Iteration Cap): Luôn đặt
max_iterations = 3(tối đa 4). Mỗi vòng lặp ngốn khoảng 3.000 – 5.000 token. Nếu thả trôi cho Agent tự quyết định khi gặp chủ đề mơ hồ, nó có thể loop 15-20 lần, đốt sạch $10 – $15 tiền API chỉ trong 1 giờ. - Cắt gọt Buffer Text: Giới hạn
max_chars = 4000(~1.000 token) cho mỗi URL. Một số trang báo nhúng mã script hoặc trang Wikipedia dài hơn 20.000 từ. Cào 3 trang như vậy mà không cắt gọt sẽ làm nổ context window 128k ngay vòng đầu. - Giới hạn tài nguyên bằng Systemd: Tránh chạy script nền dạng
nohuphoặctmuxthủ công. Hãy cấu hình systemd service với hạn ngạch RAM cụ thể để ngăn rò rỉ bộ nhớ làm sập database chạy chung VPS:
# /etc/systemd/system/deep-research-worker.service
[Unit]
Description=Deep Research Agent Worker
After=network.target

[Service]
Type=simple
User=ubuntu
WorkingDirectory=/opt/open-deep-research
ExecStart=/opt/open-deep-research/venv/bin/python main.py
Restart=on-failure
RestartSec=10s
MemoryMax=1.5G

[Install]
WantedBy=multi-user.target
Sau khi kích hoạt service, dùng lệnh systemctl status deep-research-worker để kiểm tra tiến trình và theo dõi log realtime bằng journalctl -u deep-research-worker -f nhằm phát hiện sớm các IP bị search engine chặn bot hoặc dính CAPTCHA.