Cơn ác mộng 2 giờ sáng: Khi database sụp nguồn và PagerDuty réo liên tục
2 giờ sáng, chuông PagerDuty réo inh ỏi. Máy chủ database chính (Primary) xử lý đơn hàng đột ngột sập nguồn do lỗi phần cứng. Tỷ lệ lỗi 500 trên dashboard Grafana dựng đứng. Bạn phải bật dậy, mở laptop với đôi mắt kèm nhèm để SSH vào replica. Lúc này, áp lực đè nặng: kiểm tra vị trí binlog, gõ lệnh promote node phụ lên làm node chính, rồi cuống cuồng sửa IP database trên từng con microservice.
Toàn bộ quy trình thủ công đó đốt sạch 45 phút downtime quý giá. Hậu quả là hơn 1.200 giỏ hàng bị bỏ dở, khách hàng réo support liên tục và cả team mất trắng một buổi sáng để giải trình với ban giám đốc. Vấn đề cốt lõi không nằm ở tay nghề trực chiến. Sai lầm nằm ở chỗ: chúng ta đang phó mặc tính sống còn của hệ thống cho các thao tác gõ lệnh bằng tay giữa đêm.
Vì sao mô hình Replication truyền thống không còn đủ an toàn?
Mô hình Source – Replica (Master – Slave) cổ điển từng phục vụ tốt cho các hệ thống nhỏ. Nhưng khi bước vào môi trường tải cao, ba điểm yếu chí mạng sau sẽ lộ rõ:
- Đồng bộ bất đồng bộ (Asynchronous): Node chính ghi dữ liệu cục bộ xong là trả kết quả thành công cho client ngay. Nó không cần biết replica đã nhận được event hay chưa. Nếu node chính lăn ra chết trước khi kịp đẩy binlog qua mạng, dữ liệu của những transaction cuối cùng sẽ bốc hơi vĩnh viễn.
- Không có cơ chế tự phục hồi (No Auto-failover): Bản thân MySQL server truyền thống không có năng lực tự phát hiện node chết để bầu node mới. Mọi quyết định thăng cấp node đều phụ thuộc vào con người hoặc script bên ngoài.
- Thảm họa Split-brain: Khi tự viết script failover, chỉ cần mạng chập chờn 5-10 giây khiến script mất kết nối với Primary, nó sẽ vội vàng biến Replica thành Primary thứ hai. Lúc mạng thông trở lại, hai node cùng nhận lệnh ghi với cùng một dải auto-increment ID. Hậu quả là dữ liệu xung đột tan nát và gần như không thể cứu vãn.
So sánh các giải pháp High Availability cho MySQL
Kỹ sư hạ tầng thường đứng trước ba lựa chọn phổ biến khi muốn loại bỏ điểm nghẽn Single Point of Failure (SPOF):
- Master-Slave kết hợp Orchestrator và Keepalived: GitHub Orchestrator quản lý topology cực tốt. Tuy nhiên, bạn phải dựng thêm cụm Raft riêng cho Orchestrator, cấu hình Virtual IP và bảo trì nhiều service phụ trợ đi kèm.
- Percona XtraDB Cluster / Galera Cluster: Giải pháp này dùng cơ chế chứng thực ghi đa điểm (Multi-master). Dù nhân bản dữ liệu rất chặt chẽ, Galera lại can thiệp sâu vào tầng transaction của InnoDB. Khi gặp tải ghi đồng thời cao trên cùng một tập dữ liệu, tỷ lệ rollback do certification failure sẽ tăng vọt.
- MySQL InnoDB Cluster (Group Replication + MySQL Shell): Đây là bộ giải pháp chính chủ do Oracle phát triển trọn gói từ MySQL 5.7 và tối ưu mạnh trên MySQL 8.0. Nó dùng giao thức đồng thuận Paxos (thông qua engine XCom) để chốt transaction giữa đa số các node. Điểm cộng lớn nhất là khả năng tự bầu Primary mới chỉ trong 2-3 giây mà không cần cài thêm công cụ bên thứ ba.
Kiến trúc chuẩn của một cụm MySQL InnoDB Cluster
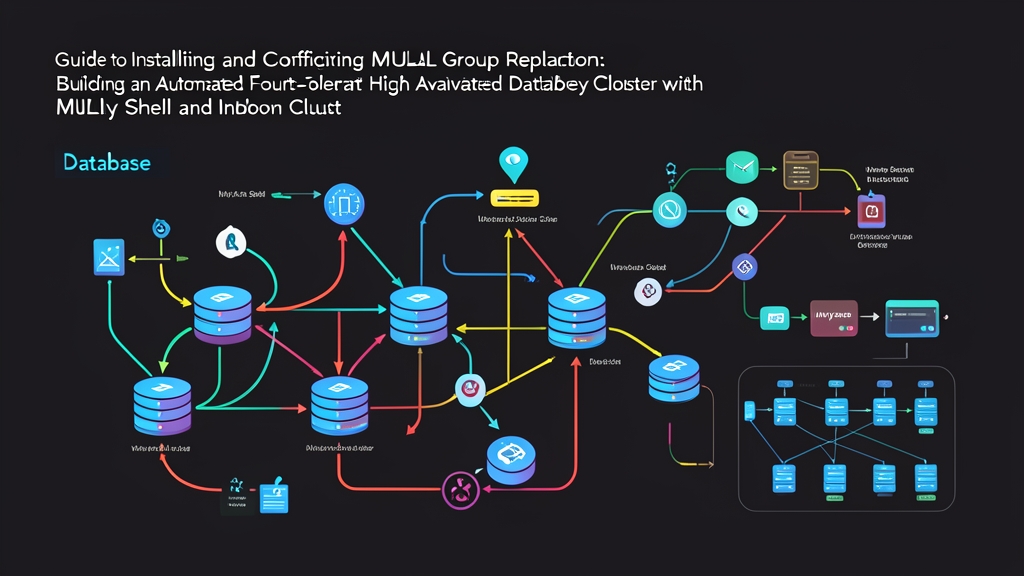
Thay vì phải cấu hình chắp vá hàng tá file config, InnoDB Cluster gói gọn toàn bộ kiến trúc High Availability vào ba mảnh ghép đồng bộ:
- Group Replication: Trái tim của cụm. Đảm bảo dữ liệu phân tán an toàn theo nguyên tắc đồng thuận số đông (Quorum).
- MySQL Shell (AdminAPI): Bộ công cụ CLI thế hệ mới hỗ trợ Python và JavaScript. Bạn có thể provision, cấu hình và join node vào cụm bằng vài hàm gọi ngắn gọn.
- MySQL Router: Tầng proxy siêu nhẹ nằm ngay trên app server. Nó tự cập nhật topology của cluster và điều hướng truy vấn ghi về port 6446 (Primary), đọc về port 6447 (Replica).
Bước 1: Chuẩn bị hạ tầng
Để đạt trạng thái Quorum (số đông quá bán) và sống sót khi có 1 node chết, bạn cần tối thiểu 3 node vật lý hoặc 3 VPS riêng biệt. Không nên đặt chung trên một host ảo hóa:
- Node 1:
192.168.1.11(mysql-node1) - Node 2:
192.168.1.12(mysql-node2) - Node 3:
192.168.1.13(mysql-node3)
Bước 2: Chuẩn hóa file cấu hình my.cnf trên 3 node
Mở file /etc/mysql/mysql.conf.d/mysqld.cnf trên từng server. Thêm các thông số bắt buộc để kích hoạt GTID và hệ thống tracking write set:
[mysqld]
server_id = 1 # Đổi thành 2 và 3 trên các máy tương ứng
gtid_mode = ON
enforce_gtid_consistency = ON
binlog_format = ROW
binlog_checksum = NONE

# Bắt buộc với Group Replication
transaction_write_set_extraction = XXHASH64
loose-group_replication_bootstrap_group = OFF
loose-group_replication_start_on_boot = OFF

# Khai báo IP lắng nghe
bind-address = 0.0.0.0
report_host = 192.168.1.11 # Điền đúng IP của từng node
Lưu file và khởi động lại tiến trình MySQL trên cả 3 máy:
sudo systemctl restart mysql
Bước 3: Dùng MySQL Shell để tự động tinh chỉnh node
Điểm sáng nhất của MySQL Shell là khả năng rà soát lỗi cấu hình tự động. Cài đặt MySQL Shell trên Node 1:
sudo apt update && sudo apt install -y mysql-shell
Mở MySQL Shell và kết nối vào instance cục bộ:
mysqlsh [email protected]:3306
Chuyển sang chế độ JavaScript bằng lệnh \js. Tiếp theo, dùng hàm kiểm tra và sửa cấu hình tự động:
// Kiểm tra các điều kiện tiên quyết của Node 1
dba.checkInstanceConfiguration('[email protected]:3306');

// Tự động fix các biến hệ thống còn thiếu và tạo user quản trị cluster
dba.configureInstance('[email protected]:3306');
Lặp lại thao tác dba.configureInstance() cho cả Node 2 (192.168.1.12) và Node 3 (192.168.1.13). Bạn không cần phải nhớ hàng chục biến nội bộ phức tạp, MySQL Shell sẽ tự làm việc đó.
Bước 4: Khởi tạo cluster trên Node 1
Sau khi cả 3 node đã đạt chuẩn, bắt đầu tạo cụm ở chế độ Single-Primary (1 node nhận ghi, 2 node nhận đọc để tránh xung đột dữ liệu):
// Kết nối phiên làm việc tới Node 1
shell.connect('[email protected]:3306');

// Tạo cluster mang tên prodCluster
var cluster = dba.createCluster('prodCluster');
Bước 5: Gia nhập Node 2 và Node 3 vào cụm
Tại cửa sổ MySQL Shell đang mở, lần lượt kết nạp hai thành viên còn lại:
// Kết nạp Node 2
cluster.addInstance('[email protected]:3306', { recoveryMethod: 'auto' });

// Kết nạp Node 3
cluster.addInstance('[email protected]:3306', { recoveryMethod: 'auto' });
Tùy chọn recoveryMethod: 'auto' là vũ khí cực mạnh của MySQL 8. Nó kích hoạt MySQL Clone Plugin để stream trực tiếp file nhị phân từ Primary sang node mới. Một database 50GB chỉ mất chưa đầy 3 phút để đồng bộ xong mà không cần dump SQL thủ công.
Bước 6: Xác nhận trạng thái sức khỏe của cụm
Để đảm bảo cả 3 node đã nhận diện nhau trơn tru, chạy lệnh:
cluster.status();
Màn hình sẽ hiển thị cấu trúc JSON chi tiết. Hãy chú ý hai chỉ số then chốt:
"status": "OK",
"topology": {
    "192.168.1.11:3306": { "mode": "R/W", "role": "HA", "status": "ONLINE" },
    "192.168.1.12:3306": { "mode": "R/O", "role": "HA", "status": "ONLINE" },
    "192.168.1.13:3306": { "mode": "R/O", "role": "HA", "status": "ONLINE" }
}
Khi toàn bộ danh sách hiển thị ONLINE, hệ thống đã sẵn sàng đón nhận traffic thực tế.
Bước 7: Mô phỏng sự cố thực tế để kiểm tra failover
Đừng bao giờ đưa một cụm HA vào production nếu bạn chưa tự tay thử giết nó. Hãy ép tắt tiến trình MySQL trên Primary (Node 1):
# Chạy trực tiếp trên terminal của Node 1
sudo systemctl stop mysql
Ngay lập tức, kết nối MySQL Shell vào Node 2 để theo dõi phản ứng của cụm:
mysqlsh [email protected]:3306
var cluster = dba.getCluster('prodCluster');
cluster.status();
Trong vòng 2 đến 3 giây, hai node còn lại sẽ nhận thấy Node 1 mất heartbeat. Chúng tiến hành bỏ phiếu Quorum và thăng cấp Node 2 lên làm R/W (PRIMARY) mới. Node 1 tự động chuyển sang nhãn (MISSING). Toàn bộ quá trình diễn ra êm thấm, ứng dụng không hề bị kẹt lock.
Kinh nghiệm thực chiến khi chạy Production
- Bắt buộc mọi bảng phải có Primary Key: Group Replication dùng cơ chế chứng thực ghi dựa trên khóa chính. Nếu bảng không có Primary Key, cluster sẽ từ chối các câu lệnh
INSERT/UPDATEtrên bảng đó. - Khống chế Network Latency dưới 5ms: Vì mỗi lệnh ghi cần xác nhận từ đa số node, ping giữa các node càng cao thì latency của app càng tăng. Hãy giữ các node trong cùng một Virtual Private Cloud (VPC) hoặc Local Area Network.
- Luôn đi kèm MySQL Router: Đừng bao giờ hardcode IP của từng node vào backend. Cài đặt MySQL Router ngay trên máy chủ ứng dụng để nó tự động nhận biết node nào vừa được thăng cấp lên làm Primary.