Quick start: Dựng Portkey AI Gateway trong 5 phút
Không cần đăng ký cloud rườm rà. Bạn có thể tự host bản mã nguồn mở của Portkey Gateway ngay trên máy local hoặc server riêng bằng Docker.
Kéo và chạy container Portkey Gateway trên cổng 8787:
# Chạy Portkey Gateway mã nguồn mở bằng Docker
docker run -d -p 8787:8787 --name portkey-gateway portkeyai/gateway:latest
Sau khi container chạy, Gateway đóng vai trò proxy trung gian. Mọi request gửi tới OpenAI, Anthropic hay Gemini giờ đây sẽ đi qua địa chỉ http://localhost:8787/v1.
Cài đặt SDK Python:
pip install portkey-ai openai
Gửi request đầu tiên qua Gateway bằng chính OpenAI SDK quen thuộc:
from openai import OpenAI

# Trỏ OpenAI client về Portkey Gateway local
client = OpenAI(
    api_key="sk-your-openai-api-key",
    base_url="http://localhost:8787/v1",
    default_headers={
        "x-portkey-provider": "openai"
    }
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Giải thích ngắn gọn: AI Gateway là gì?"}]
)

print(response.choices[0].message.content)
Đổi base_url, thêm header x-portkey-provider. Thế là xong! Toàn bộ logic xử lý kết quả ở backend giữ nguyên 100%.
Tại sao hệ thống production không nên gọi thẳng LLM API?
Gọi trực tiếp OpenAI từ code backend giống như đưa thẻ tín dụng công ty cho từng nhân viên quẹt tự do. Khi nhà cung cấp sập (lỗi 500 hoặc 503), toàn bộ app của bạn đơ theo. Tệ hơn, nếu ai đó lỡ viết một vòng lặp while True không có điểm dừng, hóa đơn API có thể vọt lên hàng nghìn USD chỉ sau một đêm.
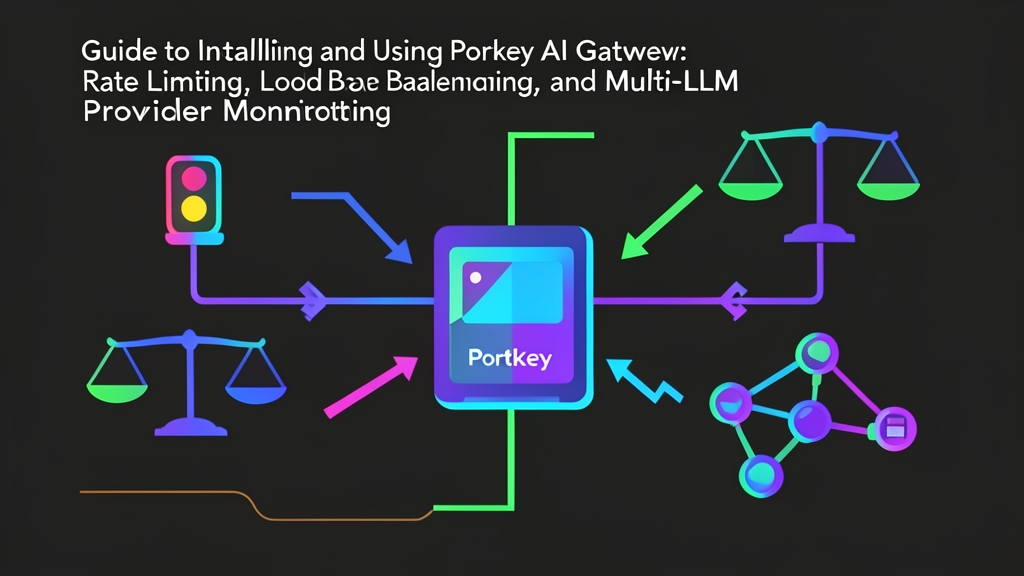
Portkey AI Gateway là chốt chặn nằm giữa ứng dụng và các mô hình AI. Nó giải quyết triệt để 4 bài toán đau đầu nhất:
1. Cân bằng tải (Load Balancing) và Dự phòng (Fallback)
Đừng bao giờ bỏ toàn bộ trứng vào một giỏ. Bạn hoàn toàn có thể chia tải: 70% request qua OpenAI, 30% qua Anthropic. Khi OpenAI bất ngờ dính lỗi 429 Too Many Requests, Gateway tự chuyển hướng request đó sang Claude 3.5 Sonnet hoặc Gemini 1.5 Flash. Toàn bộ quá trình diễn ra chỉ mất vài mili-giây, người dùng cuối không hề nhận ra sự gián đoạn.
2. Chốt chặn ngân sách và Rate Limiting
Bạn dễ dàng khóa trần cho từng phòng ban hoặc từng feature. Ví dụ: bot nội bộ của team Marketing chỉ được gọi tối đa 60 requests/phút và trần ngân sách 15 USD/ngày. Vượt ngưỡng? Gateway lập tức chặn đứng request ngay tại cửa ngõ. Thẻ tín dụng của công ty luôn an toàn.
3. Giảm chi phí và độ trễ nhờ Caching
Rất nhiều user đặt những câu hỏi na ná nhau. Portkey hỗ trợ cả Simple Cache (khớp chính xác chuỗi ký tự) lẫn Semantic Cache (hiểu ngữ nghĩa câu hỏi bằng vector search). Khi gặp câu hỏi trùng nghĩa đã trả lời trước đó, Gateway móc ngay kết quả từ Redis ra trả về. Độ trễ giảm từ 2 giây xuống dưới 20ms, và bạn không mất một xu tiền token nào.
4. Giám sát tập trung (Observability)
Mọi request đều để lại nhật ký: danh tính user, model sử dụng, độ trễ và số token input/output. Bạn không cần phải mở cùng lúc 3 tab dashboard của OpenAI, Anthropic và Google Cloud chỉ để tính tiền chia về từng dự án.
Cấu hình nâng cao: Fallback, Load Balancing và Virtual Keys
Điểm mạnh nhất của Portkey nằm ở cơ chế Config JSON. Toàn bộ logic định tuyến phức tạp nằm gọn trong file cấu hình, không cần sửa lại code nghiệp vụ.
Chiến lược Fallback tự động khi có sự cố
Đoạn cấu hình sau ưu tiên gọi GPT-4o. Nếu OpenAI trả về mã 429 hoặc 5xx, hệ thống tự động nhảy sang Claude 3.5 Sonnet:
import json
from portkey_ai import Portkey

gateway_config = {
    "strategy": {
        "mode": "fallback"
    },
    "targets": [
        {
            "provider": "openai",
            "api_key": "sk-openai-key",
            "override_params": {"model": "gpt-4o"}
        },
        {
            "provider": "anthropic",
            "api_key": "sk-ant-claude-key",
            "override_params": {"model": "claude-3-5-sonnet-20241022"}
        }
    ]
}

client = Portkey(
    base_url="http://localhost:8787/v1",
    config=json.dumps(gateway_config)
)

response = client.chat.completions.create(
    messages=[{"role": "user", "content": "Tóm tắt báo cáo tài chính quý 3."}]
)
print(response.choices[0].message.content)
Cân bằng tải theo trọng số (Weighted Load Balancing)
Trường hợp bạn có 2 tài khoản OpenAI ở các tổ chức khác nhau hoặc muốn chia tải giữa OpenAI và Azure OpenAI để tận dụng tối đa quota TPM (Tokens Per Minute):
{
  "strategy": {
    "mode": "loadbalance"
  },
  "targets": [
    {
      "provider": "openai",
      "api_key": "sk-account-tier-4",
      "weight": 0.7
    },
    {
      "provider": "azure-openai",
      "api_key": "azure-api-key",
      "weight": 0.3
    }
  ]
}
Cấu hình này tự động đẩy 70% request sang tài khoản chính và 30% sang Azure. Quota của cả hai bên đều được tận dụng tối đa mà không tài khoản nào bị nghẽn.
Kinh nghiệm thực chiến khi đưa Portkey lên Production
1. Ghép đôi OpenAI với Azure OpenAI để dập lỗi 429
Vào khung giờ cao điểm, các tài khoản OpenAI Tier thấp rất hay đụng trần rate limit. Kinh nghiệm thực tế: hãy cấu hình OpenAI làm target chính, fallback sang Azure OpenAI ở region lân cận (như Singapore hoặc Japan East), kèm retry 3 lần với exponential backoff. Thiết lập này từng giúp hệ thống bên mình kéo tỷ lệ lỗi trả về cho user từ gần 4% xuống chỉ còn 0.02%.
2. Quản lý truy cập bằng Virtual Key
Đừng bao giờ phát API key gốc của OpenAI cho dev mang vào dự án, nhất là khi làm việc với team outsource. Dùng Virtual Key của Portkey tiện hơn nhiều. Bạn chỉ cấp một chuỗi alias. Khi ai đó rời team hoặc key vô tình bị đẩy lên Git, bạn chỉ mất đúng 3 giây để thu hồi Virtual Key trên dashboard của Gateway mà không làm gián đoạn các microservices đang chạy production.
3. Tiết kiệm 30-40% chi phí với Semantic Cache
Với các ứng dụng như bot hỗ trợ khách hàng hay chatbot tra cứu văn bản nội bộ, có tới 35-40% câu hỏi mang ý nghĩa tương tự nhau dù hành văn khác biệt. Kết nối Portkey với Redis hoặc Qdrant để bật Semantic Cache với ngưỡng tương đồng (threshold) khoảng 0.85-0.9. Kết quả: hóa đơn token giảm gần một nửa, còn tốc độ phản hồi nhanh hơn gấp 5 lần.