Bối cảnh: Khi bản sao lưu chỉ tồn tại trên lý thuyết
2 giờ 15 phút sáng, điện thoại rung liên tục. PagerDuty báo phân vùng NVMe chứa PostgreSQL trên production bị hỏng sector vật lý. Mình bật dậy mở terminal, ssh thẳng vào node dự phòng. Trong đầu vẫn đinh ninh dữ liệu đã an toàn vì cronjob BorgBackup chạy đều đặn lúc 1 giờ sáng mỗi ngày. Thế nhưng, khi gõ lệnh borg list để tìm archive mới nhất, màn hình trả về một kết quả lạnh gáy: bản snapshot gần nhất được tạo từ… 23 ngày trước.
Lục lại log hệ thống mới vỡ lẽ: thư mục NFS mount từ NAS SAN trúng đợt bảo trì nâng cấp firmware, sau đó bị mount lại với quyền read-only. Lệnh borg create lập tức văng lỗi và trả về exit code 2. Đáng tiếc, file crontab trước đó lại kết thúc bằng đoạn redirect tai hại > /dev/null 2>&1. Job chết âm thầm suốt hơn ba tuần. Không email cảnh báo. Không ai hay biết.
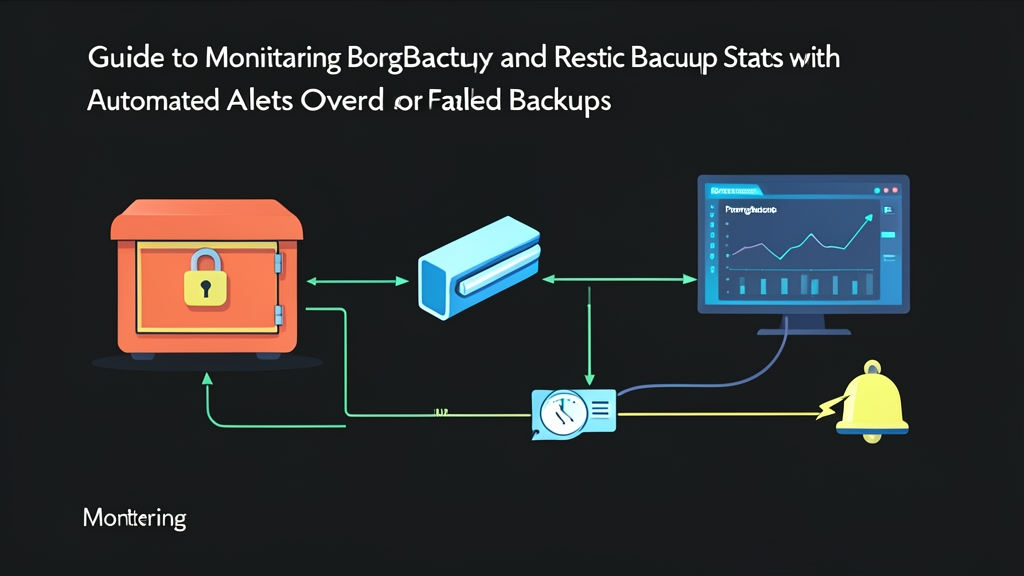
Cả BorgBackup lẫn Restic đều chống trùng lặp (deduplication) và nén dữ liệu cực tốt. Tuy nhiên, bản chất của chúng là các tiến trình batch job chạy rồi thoát. Trong khi đó, Prometheus lại hoạt động theo cơ chế pull định kỳ. Khi cronjob đã tắt, Prometheus không còn endpoint nào để cào metrics.
Giải pháp bền bỉ nhất trên Linux là dùng Textfile Collector của Node Exporter. Cơ chế rất đơn giản: script backup sau khi hoàn thành sẽ xuất kết quả ra một file text tĩnh theo đúng cú pháp Prometheus. Node Exporter sẽ tự động nuốt file này và phơi metrics ra cho Prometheus server scrape.
Cài đặt Textfile Collector
Mô hình này không đòi hỏi cài thêm daemon phụ trợ hay Pushgateway phức tạp. Ta tận dụng chính node_exporter đang túc trực trên node sao lưu.
1. Cấu hình thư mục chứa metric
Tạo một thư mục riêng để lưu file metric tạm thời, sau đó phân quyền chuẩn cho user chạy Node Exporter:
sudo mkdir -p /var/lib/node_exporter/textfile_collector
sudo chown -R prometheus:prometheus /var/lib/node_exporter/textfile_collector
sudo chmod 775 /var/lib/node_exporter/textfile_collector
Mở file cấu hình systemd của Node Exporter (thường nằm tại /etc/systemd/system/node_exporter.service) và khai báo thêm cờ --collector.textfile.directory:
ExecStart=/usr/local/bin/node_exporter \
  --collector.textfile.directory=/var/lib/node_exporter/textfile_collector
Reload daemon và khởi động lại dịch vụ:
sudo systemctl daemon-reload
sudo systemctl restart node_exporter
Cấu hình chi tiết
1. Viết wrapper script ghi metric theo cơ chế atomic
Quy tắc sống còn khi ghi metric dạng file text: tuyệt đối không dùng toán tử > để ghi thẳng vào file .prom. Hãy luôn xuất dữ liệu ra một file tạm rồi dùng lệnh mv để ghi đè. Nếu Prometheus cào dữ liệu trúng tích tắc file đang rỗng hoặc ghi dở, hệ thống sẽ parse lỗi và drop toàn bộ metrics của job.
Dưới đây là wrapper script hoàn chỉnh cho BorgBackup:
#!/usr/bin/env bash
set -uo pipefail

PROM_DIR="/var/lib/node_exporter/textfile_collector"
TARGET_NAME="db_production_borg"
PROM_FILE="${PROM_DIR}/backup_${TARGET_NAME}.prom"
TEMP_FILE="${PROM_FILE}.$$.tmp"

START_TIME=$(date +%s)
EXIT_CODE=0

# Khai báo credential và target
export BORG_PASSPHRASE="YourSecretPassphraseHere"
export BORG_REPO="/mnt/backup_storage/borg_repo"

# Chạy backup thực tế
borg create --stats \
  ::"backup-{now:%Y-%m-%d_%H-%M-%S}" \
  /var/lib/postgresql/data 2>/tmp/borg_err.log || EXIT_CODE=$?

END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Borg quy định: 0 = thành công, 1 = cảnh báo, 2 = lỗi nghiêm trọng
SUCCESS=1
if [ "$EXIT_CODE" -ne 0 ]; then
  SUCCESS=0
fi

# Bóc tách kích thước archive thực tế bằng jq
ORIGINAL_SIZE=0
DEDUP_SIZE=0
if [ "$SUCCESS" -eq 1 ]; then
  ORIGINAL_SIZE=$(borg info --last 1 --json | jq '.archives[0].stats.original_size' 2>/dev/null || echo 0)
  DEDUP_SIZE=$(borg info --last 1 --json | jq '.archives[0].stats.deduplicated_size' 2>/dev/null || echo 0)
fi

# Ghi metric ra file tạm
cat <<EOF > "${TEMP_FILE}"
# HELP backup_last_run_timestamp_seconds Thoi diem ket thuc backup lan gan nhat
# TYPE backup_last_run_timestamp_seconds gauge
backup_last_run_timestamp_seconds{target="${TARGET_NAME}"} ${END_TIME}

# HELP backup_status_success Trang thai backup (1 = thanh cong, 0 = that bai)
# TYPE backup_status_success gauge
backup_status_success{target="${TARGET_NAME}",exit_code="${EXIT_CODE}"} ${SUCCESS}

# HELP backup_duration_seconds Thoi gian chay backup tinh bang giay
# TYPE backup_duration_seconds gauge
backup_duration_seconds{target="${TARGET_NAME}"} ${DURATION}

# HELP backup_original_bytes Dung luong du lieu goc truoc khi nen
# TYPE backup_original_bytes gauge
backup_original_bytes{target="${TARGET_NAME}"} ${ORIGINAL_SIZE}

# HELP backup_dedup_bytes Dung luong thuc te ghi vao repo sau khi deduplicate
# TYPE backup_dedup_bytes gauge
backup_dedup_bytes{target="${TARGET_NAME}"} ${DEDUP_SIZE}
EOF

# Ghi đè nguyên tử (atomic rename) và phân quyền đọc cho prometheus
mv "${TEMP_FILE}" "${PROM_FILE}"
chmod 644 "${PROM_FILE}"

exit "$EXIT_CODE"
Nếu bạn đang sử dụng Restic, chỉ cần thay đổi phần thân thực thi lệnh:
# Cấu hình Restic đẩy thẳng lên S3 / MinIO
export RESTIC_PASSWORD="SecretPass123"
export RESTIC_REPOSITORY="s3:https://s3.ap-southeast-1.amazonaws.com/company-backup/restic"
export AWS_ACCESS_KEY_ID="AKIAIOSFODNN7EXAMPLE"
export AWS_SECRET_ACCESS_KEY="wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY"

restic backup /var/lib/postgresql/data --json 2>/tmp/restic_err.log || EXIT_CODE=$?
2. Thiết lập Prometheus Alert Rules
Lưu quy tắc cảnh báo tại /etc/prometheus/rules/backup_alerts.yml:
groups:
  - name: backup_monitoring_alerts
    rules:
      - alert: BackupJobFailed
        expr: backup_status_success == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Sao lưu thất bại trên target {{ $labels.target }}"
          description: "Job backup {{ $labels.target }} văng exit code {{ $labels.exit_code }}. Hãy kiểm tra ngay log tại server."

      - alert: BackupJobOverdue
        expr: (time() - backup_last_run_timestamp_seconds) > 97200
        for: 15m
        labels:
          severity: critical
        annotations:
          summary: "Bản sao lưu quá hạn trên target {{ $labels.target }}"
          description: "Đã hơn 27 giờ trôi qua nhưng target {{ $labels.target }} chưa có snapshot mới. Cronjob có thể đã chết hẳn."

      - alert: BackupDurationTooLong
        expr: backup_duration_seconds > 14400
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Thời gian backup kéo dài bất thường trên {{ $labels.target }}"
          description: "Tiến trình backup ngốn hơn 4 tiếng, dấu hiệu nghẽn băng thông mạng hoặc disk I/O quá tải."
Tại sao lại là con số 97.200 giây (27 giờ) mà không phải 24 giờ? Khi mới vận hành hệ thống, mình từng đặt ngưỡng tròn 86.400 giây cho job chạy mỗi 1 giờ sáng. Hôm nào database phát sinh nhiều write load, snapshot chạy dôi thêm 20 phút là Alertmanager lập tức réo còi lúc nửa đêm. Con số 27 giờ tạo ra một khoảng đệm an toàn 3 tiếng, đủ cho backup trễ giờ hoàn tất mà không gây ra báo động giả (alert fatigue).
Kiểm tra & Vận hành thực tế
1. Kiểm tra metric tại node local
Thực thi script một lần bằng quyền root để kiểm tra luồng tạo file:
sudo /usr/local/bin/run_borg_backup.sh
Truy vấn port 9100 của Node Exporter để xác nhận exporter đã đọc được metric:
curl -s http://localhost:9100/metrics | grep backup_
Dữ liệu trả về chuẩn chỉnh sẽ có cấu trúc như sau:
backup_dedup_bytes{target="db_production_borg"} 482344960
backup_duration_seconds{target="db_production_borg"} 184
backup_last_run_timestamp_seconds{target="db_production_borg"} 1730282400
backup_original_bytes{target="db_production_borg"} 12884901888
backup_status_success{exit_code="0",target="db_production_borg"} 1
2. Xác thực trên Prometheus Expression Browser
Trên giao diện Prometheus Web UI, hãy nhập biểu thức sau để theo dõi độ trễ backup theo thời gian thực:
(time() - backup_last_run_timestamp_seconds) / 3600
Đồ thị chuẩn sẽ có hình răng cưa đều đặn dao động từ 0 đến 24. Khi đường biểu đồ vượt qua vạch 27, alert quá hạn sẽ lập tức được bắn vào Slack hoặc Telegram của team trực.
Muốn test thử kịch bản lỗi? Bạn chỉ việc mở file .prom và sửa backup_status_success thành 0. Đúng 1 phút sau, tab Alerts trên Prometheus sẽ chuyển từ vàng (Pending) sang đỏ (Firing).
3. Thay thế Cron bằng Systemd Timer để chống xung đột job
Crontab truyền thống có một nhược điểm chí mạng: nó vẫn kích hoạt job mới ngay cả khi job cũ đang chạy dở. Khi database đạt dung lượng 500GB hay 1TB, backup có thể mất hàng giờ. Hai job chạy đè lên nhau sẽ khiến I/O nghẽn đứng máy và khóa luôn Borg lockfile.
Giải pháp chuẩn chỉnh là tách thành một cặp Systemd Service và Systemd Timer. Systemd sẽ tự động bỏ qua lượt chạy mới nếu service trước đó chưa kết thúc.
Tạo service unit tại /etc/systemd/system/borg-backup.service:
[Unit]
Description=Borg Backup Service with Prometheus Textfile Metrics
After=network-online.target

[Service]
Type=oneshot
ExecStart=/usr/local/bin/run_borg_backup.sh
User=root
TimeoutSec=21600
Khai báo lịch chạy tại /etc/systemd/system/borg-backup.timer:
[Unit]
Description=Run Borg Backup daily at 1:00 AM

[Timer]
OnCalendar=*-*-* 01:00:00
Persistent=true
RandomizedDelaySec=300

[Install]
WantedBy=timers.target
Kích hoạt timer:
sudo systemctl daemon-reload
sudo systemctl enable --now borg-backup.timer
sudo systemctl list-timers borg-backup.timer
Thông số Persistent=true đảm bảo rằng nếu server vô tình khởi động lại đúng khung giờ 1h sáng, backup sẽ được chạy bù ngay khi máy online thay vì bị bỏ qua hoàn toàn.